

目次
パンゲノム(pangenome)とは、同じ生物種の多くの個体のゲノムをまとめた「ゲノムの全体集合」のことです。ヒトでは、世界中の多様な人のゲノムを束ねた「ヒトパンゲノム」が、国際コンソーシアムHPRCによって作られています。これまで遺伝子検査の基準だった参照配列GRCh38は、1本の直線の配列でした。パンゲノムは、人による違いを「分かれ道」として持つ地図です。
⏱️ 30秒でわかる要約
🧬 Q. パンゲノムとは何ですか?
同じ生物種の多くの個体のゲノムを集めた「ゲノムの全体集合」です。もとは細菌の研究から生まれた言葉で、全員に共通する部分(コアゲノム)と、一部の個体だけが持つ部分に分けて考えます。
🧬 Q. ヒトパンゲノムと従来の参照配列GRCh38の違いは?
GRCh38は20人あまりのDNAをつないだ1本の直線の配列で、大部分が1人に由来します。ヒトパンゲノムは多くの人のゲノムを分かれ道のあるグラフとして束ね、人による違いをそのまま持てます。
🧬 Q. ヒトパンゲノムは何人分ですか?
2023年の最初の版は47人分(94本のハプロタイプ)でした。2025年5月の第2版では232人に広がり、東京大学など国際的なパートナーの試料も加わっています。
🧬 Q. パンゲノム解析で何がよくなりますか?
最初の版を使った解析では、GRCh38を使う方法に比べて小さな変異の見つけ間違いが34%減り、1本のハプロタイプあたりに見つかる構造変異が104%増えました。
🧬 Q. もう病院の遺伝子検査で使われていますか?
まだ研究で使われ始めた段階です。臨床の遺伝子検査の多くは、いまもGRCh38などの直線の参照配列を基準にしています。パンゲノムは、これから検査の精度を底上げしていく土台と考えるのが適切です。
🧬 パンゲノム(ヒトパンゲノム)の基本情報
| 項目 | 内容 |
|---|---|
| 読み方・英語 | パンゲノム/pangenome(pan-genome) |
| ひとことで言うと | 同じ生物種の多くの個体のゲノムをまとめた「ゲノムの全体集合」[1] |
| 言葉の始まり | 2005年、細菌(B群溶血性レンサ球菌)8株のゲノム比較で提唱[1] |
| ヒトの代表例 | HPRC(ヒトパンゲノム・リファレンス・コンソーシアム)のヒトパンゲノム。第1版47人(2023年)、第2版232人(2025年)[4][5] |
| 従来の参照配列 | GRCh38(1本の直線の配列)、T2T-CHM13(1人分の完全な配列) |
| 形 | 分かれ道を持つグラフ(パンゲノムグラフ) |
| 得意なこと | 構造変異や、よく似た配列がくり返す領域の解析 |
1. パンゲノムとは?意味と「コアゲノム」「アクセサリーゲノム」
パンゲノムとは、ある生物種の多くの個体が持つゲノムをすべて合わせた「全体集合」のことです。「パン(pan)」はギリシャ語で「すべて」を意味します。ゲノムは、ひとつの生き物が持つ遺伝情報の一式です。
この言葉は2005年に、細菌の研究から生まれました。B群溶血性レンサ球菌の8つの株のゲノムを比べたところ、株ごとに持っている遺伝子がかなり違っていました[1]。1株だけを読んでも、その菌の種が持つ遺伝子の全体像はわからなかったのです。
そこで研究者たちは、種のゲノムを次の2つに分けて考えました[1]。
● コアゲノム:すべての株が共通して持つ部分
● アクセサリーゲノム(可変ゲノム):一部の株だけが持つ部分。1つの株にしかない遺伝子も含みます
この論文では、コアゲノムは1株のゲノムのおよそ80%にあたりました。さらに、新しい株を1つ読むたびに、その株だけの遺伝子が平均で約33個ずつ見つかると見積もられました[1]。
パンゲノム解析とは
パンゲノム解析とは、たくさんの個体のゲノムを並べて、共通部分と違う部分を調べる解析のことです。細菌では薬剤耐性や病原性の遺伝子を探すのに使われます。作物では、品種ごとの違いを品種改良に役立てる研究が進んでいます。
ヒトでも考え方は同じです。人と人のゲノムの大部分は共通です。それでも、ある人にはあって別の人にはない配列や、向きや数が違う配列があります。この違いをまとめて扱えるようにしたのが「ヒトパンゲノム」です。
2. なぜパンゲノムが必要?参照配列GRCh38の限界と参照バイアス
遺伝子検査では、読み取ったDNAを「参照配列(リファレンスゲノム)」と照らし合わせて、違うところを探します。世界で長く使われてきたヒトの参照配列が、GRCh38です。ヒトゲノムの住所(座標)も、遺伝子データベースの多くも、この配列を基準に作られています。
ところがGRCh38は、20人あまりのDNAをつなぎ合わせた1本の配列です。しかもその大部分は、1人の人に由来しています[2]。1本の直線なので、ある場所に「Aの形とBの形がある」という違いを書き込めません。
💡 用語解説:参照配列(リファレンスゲノム)
遺伝子検査で読み取ったDNAの断片が、ゲノムのどこに当たるかを決めるための「基準の地図」です。断片を地図に当てはめ(マッピング)、地図と違う文字や並びを変異として見つけます。ヒトではGRCh38が長く標準として使われてきました。
参照バイアスとは
基準の地図とかけ離れた配列を持つ人のDNAは、地図にうまく当てはまりません。当てはまらない断片は捨てられたり、別の場所に間違って置かれたりします。その結果、変異の見落としや見間違いが起こります。これを参照バイアス(reference bias)と呼びます。
参照バイアスは、特に大きな変化で問題になります。たとえば地図にない数千文字の挿入を持つ人を考えてみます。挿入部分の断片は、地図に行き先がありません。そのため、挿入そのものが「ない」ことになってしまいます。
また、地図が特定の集団に近いほど、ほかの集団の人のデータは当てはまりにくくなります。地図の偏りは、そのまま医学的な知見の偏りにつながります[2]。
T2T-CHM13:1人分の「完全なゲノム」
GRCh38には、読み切れていない空白も残っていました。セントロメアのような、同じ配列がくり返す場所です。2022年に発表されたT2T-CHM13は、染色体の端から端(テロメアからテロメア)までを読み切った配列です[3]。
T2T-CHM13の全長は約30億5,500万塩基対です。GRCh38になかった配列を約2億塩基対加え、遺伝子の候補を1,956個(うちタンパク質をつくるもの99個)新たに示しました[3]。ただし、これは1人分のゲノムです。人による違いを表すには、たくさんの人の完全なゲノムを束ねる必要があります。そこで登場するのがヒトパンゲノムです。
3. ヒトパンゲノム(HPRC)とは?47人から232人へ
ヒトパンゲノムとは、遺伝的な背景の異なる多くの人の完全に近いゲノムを、1つのグラフにまとめた新しい参照配列です。作っているのは、米国国立ヒトゲノム研究所(NHGRI)の支援を受けた国際コンソーシアム、HPRC(Human Pangenome Reference Consortium)です[2]。
第1版(2023年):47人・94ハプロタイプ
2023年5月、HPRCは最初のヒトパンゲノム(ドラフト版)を発表しました。遺伝的に多様な47人について、父由来と母由来を分けた2本ずつ、合計94本のハプロタイプを組み立てたものです[4]。
💡 用語解説:ハプロタイプ(haplotype)
父と母から1本ずつ受け継いだ染色体の、片方ずつの並びのことです。ヒトは2本ずつ持つので、1人から2本のハプロタイプが得られます。どちらの染色体にどの変化があるかを分けて読むことを「フェージング」と呼びます。詳しくはハプロタイプとはをご覧ください。
それぞれのゲノムは、予想される配列の99%以上を、99%以上の正確さで組み立てていました。そしてGRCh38に対して、次のものを新たに書き加えました[4]。
● 人によってあったりなかったりする配列:約1億1,900万塩基対(うち約9,000万塩基対は構造変異による)
● 遺伝子の重複:1,115か所
1人中心の地図が、どれだけの情報を取りこぼしていたかがわかる数字です。
第2版(2025年)とその先
2025年5月には第2版のデータ(Release 2)が、論文の発表に先がけて公開されました。対象は232人に広がり、東京大学やイタリアのHuman Technopoleなど、国際的なパートナーの試料も加わっています[5]。組み立ての間違いはおよそ3分の1に、1文字単位の読み取り誤りは半分に減りました[5]。
2026年7月には、この第2版をまとめた論文が査読前の原稿(プレプリント)として公開されました。460本のハプロタイプを含み、米国の大規模研究「All of Us」の参加者に見られるよくある変異の99%以上を含むと報告されています[6]。ただし、まだ査読を経ていない段階の報告です。
各国のパンゲノムと日本人の参照配列
HPRC以外にも、集団ごとのパンゲノムが作られています。中国では、36の少数民族の58人から、GRCh38にない配列を約1億8,900万塩基対見つけたパンゲノムが2023年に報告されました[7]。
日本では東北大学のグループが、日本人3人のゲノムを長い配列を読む方法で組み立て、日本人の参照配列「JG1」を2021年に作りました。希少疾患の家系のエクソームを再解析したところ、病気の原因の変異を残したまま、調べる必要のある候補の数を減らせたと報告されています[8]。
🧬 主な参照配列とパンゲノムの比較
4. パンゲノム解析のしくみ:グラフゲノムとロングリード
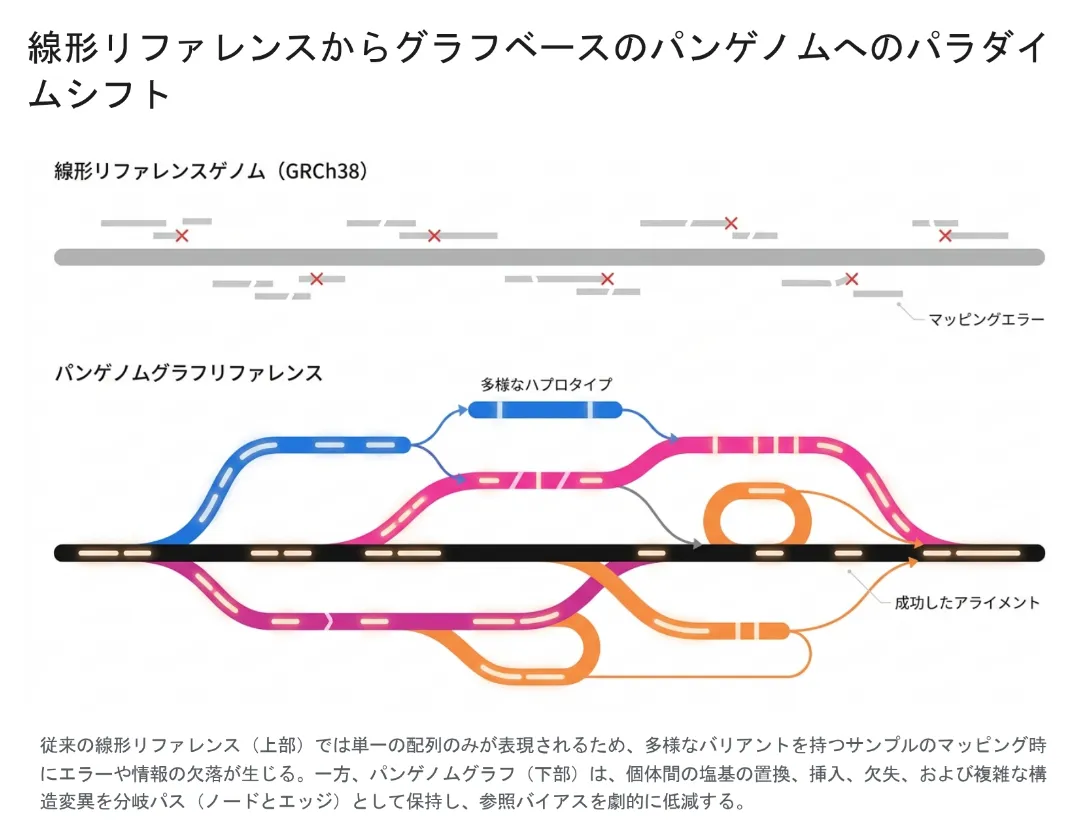
ヒトパンゲノムは、多くの人のゲノムを「分かれ道のある地図(グラフ)」として表します。みんなに共通する部分は1本の道です。人によって違う部分は、道が分かれて別のルートになります。電車の路線図をイメージするとわかりやすいでしょう。
💡 用語解説:グラフゲノム(パンゲノムグラフ)
DNAの配列を「点(ノード)」と「点をつなぐ線(エッジ)」で表した地図です。1人分の配列は、グラフの中の1本の道筋になります。直線の参照配列では書けなかった挿入や欠失、向きの逆転も、別の道として書き込めます。
完全なゲノムを組み立てる:ロングリードとアセンブリ
グラフを作るには、まず1人ひとりのゲノムを完全に近い形で組み立てる必要があります。この組み立てをアセンブリと呼びます。ここで活躍するのが、DNAを長いまま読むロングリードシーケンスです。
一般的な遺伝子検査の次世代シーケンサー(NGS)は、DNAを数百文字の短い断片にして読みます(ショートリード)。安く正確ですが、同じ配列がくり返す場所では、断片がどこから来たかを決められません。ロングリードは1万〜数十万文字を一続きで読めるので、くり返し配列をまたいでつなげます。
HPRCの第1版では、正確な長い読み(PacBio HiFi)、さらに長い読み(ナノポアシーケンサー)、両親のデータなどを組み合わせて、父由来と母由来を分けて組み立てました[4]。
検査データをグラフに当てはめる
できあがったグラフは、ふつうの遺伝子検査のデータ解析にも使えます。短い断片を、直線の地図ではなくグラフに当てはめるのです。よくある違いはすでに「分かれ道」として描かれているので、断片が行き場を失いにくくなります。
第1版のヒトパンゲノムでショートリードのデータを解析すると、GRCh38を使う方法に比べて小さな変異の見つけ間違いが34%減りました。また、1本のハプロタイプあたりに見つかる構造変異の数は104%増え、約2倍になりました[4]。
💡 用語解説:構造変異(SV)
DNAの比較的大きな部分(おおむね50塩基以上)が、欠けたり、増えたり、向きが逆になったり、別の場所へ移ったりする変化です。1文字の違い(一塩基バリアント)よりも影響が大きいことがあります。短い断片を直線の地図に当てはめる方法では、見つけにくい変化です。

🩺 院長コラム【「読めない場所」が減るということ】
遺伝子検査の結果をご家族にお伝えするとき、私が長く歯がゆく感じてきたのは、「この領域は技術的に読み取りが難しく、はっきりしたことが言えません」とお伝えせざるを得ない場面があったことです。ゲノムには、これまでの技術ではどうしても読み切れない「暗い場所」が残されていました。
パンゲノムと長い配列を読む技術は、その暗い場所を1つずつ照らしています。読めない場所が減れば、「わかりません」とお伝えする回数も減ると考えています。技術の進歩が、そのまま説明の確かさにつながっていく。遺伝医療にたずさわる者として、静かに期待している変化です。
5. ゲノム医療・遺伝子検査への影響:読みにくい遺伝子が読めるように
パンゲノムがもっとも力を発揮するのは、よく似た配列がくり返す「読みにくい遺伝子」です。こうした場所は、ショートリードと直線の参照配列では、断片がどちらの遺伝子から来たかを決めにくいのです。代表的な例を3つ紹介します。
脊髄性筋萎縮症(SMA):そっくりなSMN1とSMN2
脊髄性筋萎縮症(SMA)は、運動神経が少しずつ失われ、筋力が低下していく病気です。常染色体潜性(劣性)遺伝の形式をとります。原因はSMN1遺伝子の変化で、患者さんの約95%は、SMN1の両方のアレルでエクソン7が欠けています[9]。
難しいのは、すぐ隣にSMN2というほとんど同じ配列の遺伝子があることです。2つの違いはごくわずかです。そのため短い断片では、どちらの遺伝子を読んでいるのかを見分けにくくなります。SMN2のコピー数は症状の重さにも関わります[9]。
長い配列で読み、パンゲノムのように多くの人の配列の違いを地図に持たせれば、この領域を正しく読み分けやすくなると期待されています。
リポタンパク質(a):くり返しの数が量を決めるLPA遺伝子
血液中のリポタンパク質(a)(Lp(a))が高いことは、心筋梗塞などの危険因子です。その量は、LPA遺伝子の中の「KIV-2」という部分が何回くり返しているかに大きく左右されます[10]。
KIV-2は1回分が約5,500塩基と長く、人によってくり返しの数が大きく違います[10]。似たくり返しが何十も並ぶため、短い断片では「何番目のくり返しか」がわかりません。くり返しの中の小さな変異も見落とされやすい場所です[10]。長い読みとパンゲノムは、こうした領域の解析にも役立ちます。
HLA:ヒトゲノムで最も多様な領域の1つ
第6染色体にあるHLA(ヒト白血球抗原)の遺伝子群は、免疫・移植・薬の副作用に関わる重要な場所です。人による違いが非常に大きく、1本の直線の参照配列では表しきれません[2]。パンゲノムのグラフなら、多様なHLAの型を「分かれ道」として持たせることができます。
当院の遺伝子検査と「よく似た配列」
よく似た配列(偽遺伝子)の問題は、保因者検査でも大切です。当院の拡大版保因者検査(女性787遺伝子)の一覧には、SMN1が入っています。男性714遺伝子と組み合わせて、カップルで受けることができます。
よく似た配列の影響は、解析で大きく減らしています。それでも、まれに変化の検出を妨げることがあります。また、SMN1が片方の染色体に2つ並び、もう片方にない「2+0」型の保因者は、当院の方法では見分けられません。陰性の結果は保因者である可能性を大きく下げますが、ゼロにはしません。こうした検査の限界も、臨床遺伝専門医が検査の前にご説明します。
お母さんの血液で赤ちゃんの染色体を調べる東京のNIPT(新型出生前診断)も、血液中のDNA断片を参照配列に当てはめて解析する検査です。参照配列の進歩は、NIPTを含むゲノム検査全体の土台に関わっています。
6. パンゲノムの課題と倫理:誰もが恩恵を受けるために
パンゲノムは、まだ研究で使われ始めた段階です。病気と変異の対応を記録したデータベースの多くは、GRCh38の座標で作られています。臨床の検査に広く使われるには、従来の座標との対応づけや、検査としての性能の確認が必要です。
もう1つの課題は、公平さです。過去のゲノム研究には、一部の集団のデータに偏ってきた反省があります。HPRCは研究の中に倫理・法律・社会の専門家を組み込み、参加者にわかりやすい同意の手続きを整えています[11]。
データを誰もが使えるようにする「FAIR原則」と、データを提供した集団の権利と利益を守る「CARE原則」を両立させることも掲げています[11]。日本人を含むさまざまな集団のデータが加わるほど、どの人の検査結果も同じ確かさで読めるようになります。
🩺 院長コラム【「みんなの地図」を、日本のご家族にも】
遺伝医療の進歩は、特定の地域や集団のデータに偏って進んできました。海外の基準で作られた「標準」が、日本人にそのまま当てはまるとは限りません。遺伝カウンセリングでは、このことを常に意識しておく必要があると考えています。
パンゲノムが目指しているのは、まさに「みんなの地図」です。日本人のデータもきちんと含んだ形で成熟していけば、目の前のご家族に、より確かな情報をお届けできるようになります。技術の公平さが、そのまま医療の公平さにつながることを願っています。
よくある質問(FAQ)
Q1. パンゲノムとは何ですか?簡単に教えてください。
パンゲノムとは、同じ生物種の多くの個体のゲノムをまとめた「ゲノムの全体集合」です。2005年に細菌の研究から生まれた言葉で、全員に共通する部分(コアゲノム)と、一部の個体だけが持つ部分(アクセサリーゲノム)に分けて考えます。ヒトでは、多くの人のゲノムを束ねた「ヒトパンゲノム」が作られています。
Q2. ヒトパンゲノムと従来の参照配列GRCh38は何が違いますか?
いちばんの違いは形です。GRCh38は20人あまりのDNAをつないだ1本の直線の配列で、大部分が1人に由来します。ヒトパンゲノムは多くの人のゲノムを分かれ道のあるグラフとして束ねているので、人による違いや構造の違いをそのまま持てます。
Q3. パンゲノム解析とは何をする解析ですか?
たくさんの個体のゲノムを並べて、共通する部分と違う部分を調べる解析です。細菌では薬剤耐性や病原性の遺伝子探し、作物では品種改良に使われます。ヒトでは、検査で読んだDNAの断片をパンゲノムのグラフに当てはめ、変異をより正確に見つける解析も含みます。
Q4. T2Tとパンゲノムはどう違いますか?
T2T(テロメア・トゥ・テロメア)は、染色体の端から端までを空白なく読み切った配列のことです。2022年のT2T-CHM13は、1人分の完全なゲノムでした。パンゲノムは、こうした完全に近いゲノムを多くの人について集め、人による違いを1つのグラフにまとめたものです。
Q5. ヒトパンゲノムに日本人のデータは入っていますか?
2025年5月に公開されたHPRCの第2版(232人)には、東京大学など国際的なパートナーの試料も加わっています。日本では2021年に、日本人3人のゲノムから作った日本人の参照配列「JG1」も報告されています。
Q6. パンゲノムで遺伝子検査の精度は上がりますか?
研究では精度が上がることが示されています。最初のヒトパンゲノムを使った解析では、小さな変異の見つけ間違いが34%減り、見つかる構造変異が約2倍になりました。ただし臨床の遺伝子検査の多くは、いまも直線の参照配列を基準にしています。広く使われるには、検査としての検証が必要です。
🧬 遺伝子検査・保因者検査をご検討の方へ
ミネルバクリニックには臨床遺伝専門医が常駐しています。女性787遺伝子・男性714遺伝子の拡大版保因者検査は、オンライン診療でも受けられ、唾液や頬の粘膜の検体でも検査できます。検査の前後に、臨床遺伝専門医が検査でわかること・わからないことをご説明します。
参考文献
- [1] Tettelin H, Masignani V, Cieslewicz MJ, et al. Genome analysis of multiple pathogenic isolates of Streptococcus agalactiae: implications for the microbial “pan-genome.” Proc Natl Acad Sci U S A. 2005;102(39):13950-13955. [doi:10.1073/pnas.0506758102]
- [2] Wang T, Antonacci-Fulton L, Howe K, et al. The Human Pangenome Project: a global resource to map genomic diversity. Nature. 2022;604(7906):437-446. [doi:10.1038/s41586-022-04601-8]
- [3] Nurk S, Koren S, Rhie A, et al. The complete sequence of a human genome. Science. 2022;376(6588):44-53. [doi:10.1126/science.abj6987]
- [4] Liao WW, Asri M, Ebler J, et al. A draft human pangenome reference. Nature. 2023;617(7960):312-324. [doi:10.1038/s41586-023-05896-x]
- [5] Human Pangenome Reference Consortium. HPRC Data Release 2(2025年5月12日公開). [HPRC]
- [6] Lucas JK, et al. HPRC2: A human pangenome reference with near-complete coverage of common genetic variation. bioRxiv. 2026(査読前のプレプリント). doi:10.64898/2026.07.21.739710 [Sciety]
- [7] Gao Y, Yang X, Chen H, et al. A pangenome reference of 36 Chinese populations. Nature. 2023;619(7968):112-121. [doi:10.1038/s41586-023-06173-7]
- [8] Takayama J, Tadaka S, Yano K, et al. Construction and integration of three de novo Japanese human genome assemblies toward a population-specific reference. Nat Commun. 2021;12:226. [doi:10.1038/s41467-020-20146-8]
- [9] Prior TW, Leach ME, Finanger EL. Spinal Muscular Atrophy. In: Adam MP, et al., eds. GeneReviews®. University of Washington, Seattle; 2000 (updated). [NCBI Bookshelf NBK1352]
- [10] Coassin S, Kronenberg F. Lipoprotein(a) beyond the kringle IV repeat polymorphism: the complexity of genetic variation in the LPA gene. Atherosclerosis. 2022;349:17-35. [PubMed 35606073]
- [11] Human Pangenome Reference Consortium. Embedded ELSI(倫理的・法的・社会的課題への取り組み). [HPRC]






