

目次

📍 クイックナビゲーション
DNAやRNAの構造を学ぶと、必ず出てくるのが「5’末端(ごダッシュまったん/ファイブプライム)」と「3’末端(さんダッシュまったん/スリープライム)」という言葉です。これは、鎖のどちらの端を指しているのかを表す呼び名で、いちばんよく検索されるのは「5’末端と3’末端はどっちが先なのか」という疑問です。結論を先にいうと、DNAやRNAの新生鎖の合成は5’→3’方向に進み、翻訳ではリボソームがmRNAを5’→3’方向に読み進めます。なお、DNA・RNAポリメラーゼが読む鋳型鎖の向きは3’→5’です。配列は通常5’→3’で表記するため、「どちらを先に書くか」という意味では5’側が先です。この記事では、5’末端・3’末端とは何か、どうやって見分けるのか、なぜ向きが決まっているのか、そして5’末端・3’末端でそれぞれどんなことが起こるのかを、遺伝専門医の視点で、図と対比表を使ってわかりやすく解説します。
Q. 5’末端と3’末端は、どっちが先ですか?まず結論だけ知りたいです
A. 「先」にあたるのは5’末端です。DNAやRNAをつくるとき(合成)も、mRNAをタンパク質へ翻訳するとき(読み取り)も、向きはいつも5’末端から3’末端(5’→3’)と決まっています。これは、酵素(ポリメラーゼ)が、すでにある鎖の3’末端の水酸基(3′-OH)にしか新しい部品をつなげられないためです。だから鎖はいつも5’側から始まり、3’側へ伸びていきます。
- ➤5’末端とは → 糖の5位炭素(C5’)が鎖の端に来る側。ふつうリン酸(5′-リン酸)が付いている
- ➤3’末端とは → 糖の3位炭素(C3’)が鎖の端に来る側。水酸基(3′-OH)が付いている
- ➤向き → 合成も読み取りも必ず5’→3’。だから5’側が「起点」
- ➤見分け方 → 骨格をたどり、リン酸が露出した端が5’、水酸基(OH)が露出した端が3′
- ➤まぎらわしい別物 → タンパク質のN末端・C末端は、核酸の5’/3’末端とは別の基準の呼び名
🧬 5’末端と3’末端の基本情報(対比)
| 項目 | 5’末端 | 3’末端 |
|---|---|---|
| 糖の炭素 | 5位炭素(C5’)が末端 | 3位炭素(C3’)が末端 |
| 末端についている基 | リン酸(5′-リン酸) | 水酸基(3′-OH) |
| 合成・読み取り | 起点(5’側から始まる) | 到達点(3’側へ伸びる) |
| 二本鎖での位置 | 相手鎖の3’末端と向かい合う | 相手鎖の5’末端と向かい合う |
| mRNAでのおもな修飾 | 5’キャップ(m7G) | ポリA尾部(ポリアデニル化) |
※本記事は一般の方と遺伝・分子生物学を学ぶ方の両方に向けた用語解説です。特定の検査を勧めるものではありません。
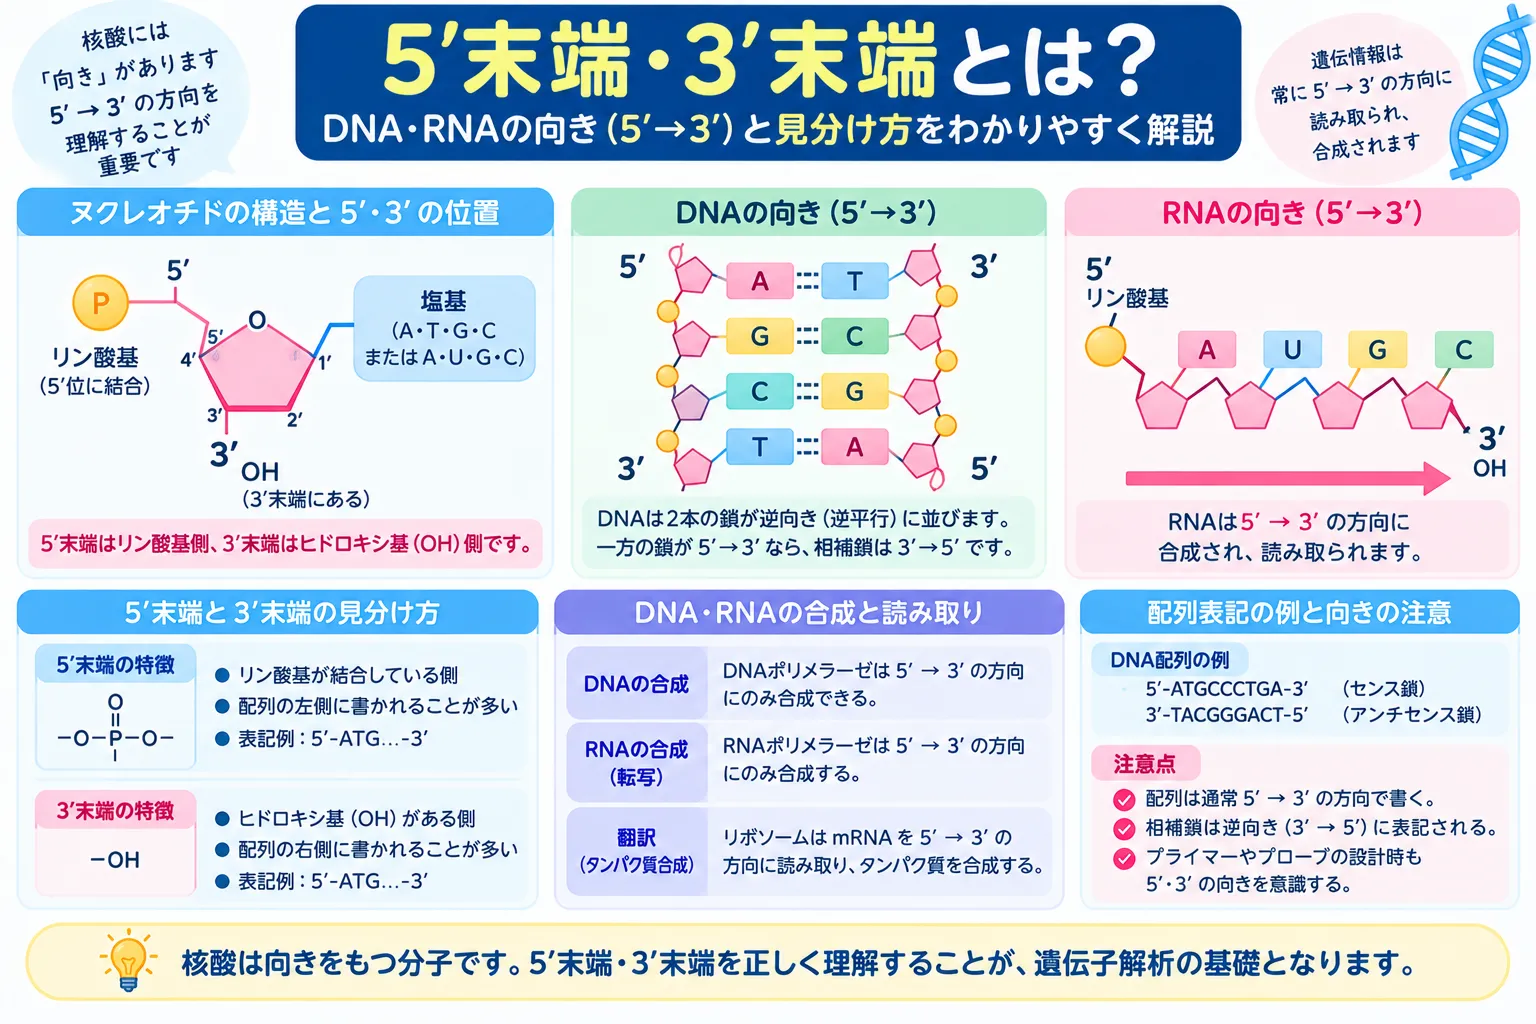
DNA・RNAの5’末端と3’末端は糖の炭素番号に由来し、新生鎖は5’→3’方向に伸長します。5’側と3’側の違いと方向性を確認するための模式図です。
1. 5’末端・3’末端とは ─ 糖の「何番目の炭素」で決まる
5’末端・3’末端とは、DNAやRNAという鎖状の分子の、両端を区別するための呼び名です。DNAもRNAも、糖・リン酸・塩基からなる小さな部品(ヌクレオチド)が、たくさんつながってできています。その骨格の中心にあるのが五炭糖(デオキシリボースまたはリボース)で、この糖を構成する5つの炭素には、塩基環の番号と区別するために「’(プライム)」を付けて1’〜5’と番号がふられています[1][2]。
💡 用語解説:糖の炭素番号(1’〜5’)
五炭糖では、塩基が結びつく炭素を1’(ワンプライム)と呼びます。糖の環(リング)は1’〜4’の4つの炭素と1つの酸素でできており、5’(ファイブプライム)の炭素は、その環の外側にC4’から突き出した炭素です。この5’炭素にリン酸が結びつき、3’炭素には水酸基(OH)が付いています[1][2]。つまり「5’」「3’」は、糖のどの番号の炭素が鎖の端に来ているかを表しているのです。
DNAやRNAの骨格は、糖とリン酸が交互につながった「糖-リン酸バックボーン」でできていて、塩基がそこから横に張り出しています。二重らせんをはしごにたとえると、糖とリン酸が両側の支柱、塩基対が段にあたります。なお、DNAの糖はデオキシリボースで2’炭素に水酸基を持たず、RNAの糖はリボースで2’炭素に水酸基を持つという違いがあります。ただし、5’末端・3’末端という「末端の考え方」そのものは、DNA・RNAに共通です[1][2]。なお、糖に塩基が結びついたものをヌクレオシド、それにさらにリン酸が付いたものをヌクレオチドと呼び、鎖の部品になるのはリン酸を持つヌクレオチドのほうです。
5’末端とは
5’末端とは、糖の5位炭素(C5’)が鎖のいちばん端に来ている側のことです。ここには通常、リン酸(5′-リン酸)が結合しています[1]。鎖の内部では、あるヌクレオチドの5′-リン酸が、隣のヌクレオチドの3′-水酸基と共有結合してつながっていきます。この結合をヌクレオチド同士をつなぐ「ホスホジエステル結合」といいます。鎖の一方の端では、この結合の相手がいないまま5′-リン酸が露出しており、それが5’末端です[2]。
3’末端とは
3’末端とは、糖の3位炭素(C3’)が鎖のいちばん端に来ている側で、ここには水酸基(3′-OH)が付いています[1]。鎖の反対側の端で、この3′-OHが結合相手を持たずに露出しているところが3’末端です。あとで詳しく述べるように、新しいヌクレオチドがつながるとき、その足がかりになるのがこの3′-OHです。5’末端がリン酸、3’末端が水酸基という「末端についている基の違い」は、5’と3’を見分けるいちばんの手がかりになります[2]。
なぜ「5’(ファイブプライム)」と読むのか
「5’」は、日本語ではしばしば「ごダッシュ」と読まれますが、英語では five-prime(ファイブプライム)と読むのが正式です。同じように3’は three-prime(スリープライム)です。ここでの「’(プライム)」は、糖の炭素の番号を、塩基の環にある原子の番号(こちらは「’」を付けない)と区別するための記号で、割り算の「ダッシュ」とは無関係です[1][2]。呼び方はどちらでも通じますが、原理を理解しておくと混乱しません。
2. 5’末端と3’末端はどっちが先? ─ 向き(5’→3’)の話
結論から言うと、「先」にあたるのは5’末端です。DNAやRNAの新生鎖は5’→3’方向に合成され、翻訳ではリボソームがmRNAを5’→3’方向に読み進めるためです。ただし、ポリメラーゼが読む鋳型鎖は3’→5’方向です[1]。「5’末端3’末端」「dna 5末端 3末端 どっち」といった検索が多いのは、この向きの感覚がつかみにくいためですが、ポイントは1つだけです。
新生鎖の合成は5’→3’方向、鋳型鎖の読み取りは3’→5’方向
DNAやRNAをつくる酵素(ポリメラーゼ)は、すでにある鎖の3’末端の水酸基(3′-OH)にしか、新しいヌクレオチドをつなげられません[1]。新しい部品は常に「いまの3’末端」に足されていくので、鎖は5’側から始まって3’側へと伸びていきます。これが「合成は5’→3’方向」という意味です。同じように、mRNAをタンパク質へ翻訳するときも、リボソームはmRNAを5’末端の側から読み進めます。したがって、新生鎖や塩基配列を通常どおり5’→3’で表す場合は、5’末端が先に書かれます。
この向きは、DNAからRNAがつくられる転写でも同じです。RNAは5’→3’方向に合成され、そのとき鋳型(いがた)として読まれるDNA鎖は3’→5’方向に読み取られます。二本鎖のうち、鋳型として使われないほうの鎖(センス鎖)は、できあがるRNAと同じ並びになります(ただしチミンTのかわりにウラシルUになります)。このように、複製・転写・翻訳のいずれでも、向きは一貫して5’→3’に保たれています。
なぜ5’→3’方向なのか(簡単に)
向きが決まっている理由は、ポリメラーゼが新しいヌクレオチドをつなぐ化学反応の仕組みにあります。反応のエネルギーは、これからつながる新しいヌクレオチド側(三リン酸として運ばれてくる材料)が持っていて、それを使って鎖の3′-OHに次の部品が結合します。この向きだからこそ、間違った部品を取り除いて付け直す「校正(プルーフリーディング)」も無理なく働きます。この深い仕組み(DNAポリメラーゼの働きやラギング鎖・岡崎フラグメントなど)は、複製のページで詳しく説明しています。ここでは「向きは5’→3’に決まっている」という結論だけ押さえれば十分です。
二本鎖は「逆平行」 ─ 5’末端と3’末端が向かい合う
DNAの二本鎖は、2本が同じ向きに並んでいるのではなく、互いに逆向きに(逆平行に)組み合わさっています[1]。一方の鎖を5’→3’にたどると、もう一方の鎖は3’→5’の向きになります。その結果、二本鎖の一端では、片方の5’末端と、もう片方の3’末端が向かい合う形になります[2]。この逆平行という性質は、塩基どうしが正しく対を組むために欠かせません。この逆平行があるからこそ、AとT(RNAではAとU)、GとCという塩基どうしが、無理なく水素結合で向かい合って対(塩基対)を組めます。「dna 5末端 3末端」を考えるときは、2本がいつも逆向きに向かい合っている、とイメージすると理解しやすくなります。
3. 5’末端と3’末端の違い・見分け方
5’末端と3’末端のいちばんはっきりした違いは、末端についている基です。5’末端にはリン酸、3’末端には水酸基(OH)が付いています[1][2]。図で鎖を見るときは、糖とリン酸が交互に並んだ骨格(糖-リン酸バックボーン)をたどり、リン酸が結合相手なしに露出している端が5’末端、水酸基が露出している端が3’末端だと見分けられます。上でまとめた対比表も、この違いを一目で確認するのに役立ちます。
図での見分け方
教科書の図では、慣習として鎖を左上を5’、右下を3′に描くことが多く、二本鎖では左の鎖が上5’・下3’、右の鎖が上3’・下5’というように、上下で5’と3’が入れかわって描かれます[1]。矢印が付いている図なら、矢印の根もとが5’、矢の先が3’です(合成・読み取りの向きに合わせてあるため)。まず「リン酸か、水酸基か」で端を判定し、次に「二本鎖では逆平行」を思い出せば、たいていの図で5’と3’を正しく読み取れます。
配列を文字で書くときにも、向きの約束があります。ふつう塩基配列は左を5’、右を3′にそろえ、5’→3’の向きで左から右へ書きます。たとえば「5′-ATGC-3’」と書けば、左端のAが5’側、右端のCが3’側です。相手の鎖は逆平行なので、その下に「3′-TACG-5’」と重ねて書けます。向きの記号(5’・3’)が省略されている配列は、特に断りがなければ5’→3’で書かれている、と考えるのが基本です[1]。
核酸の5’/3’と、タンパク質のN末端・C末端は別物
よくある混同が、核酸の5’/3’末端と、タンパク質のN末端・C末端を同じものだと思ってしまうことです。5’末端・3’末端は「核酸(DNA・RNA)」の端の呼び名で、糖の炭素の番号を基準にしています。いっぽうN末端・C末端は「タンパク質」の端の呼び名で、アミノ酸の遊離アミノ基(N末端)と遊離カルボキシ基(C末端)を基準にしています。基準になっている分子も化学的な基もまったく別です。
両者は、向きとしては対応します。mRNAは5’→3’方向に読まれ、その情報からタンパク質はN末端→C末端の向きに作られていくため、「5’側の情報が、タンパク質のN末端側になる」という関係があります。ただし「5’末端=N末端」と等号で結ぶのは誤りで、あくまで別々の分子の、別々の基準による呼び名だと理解しておくことが大切です。覚え方のコツは、数字(5’・3’)が付いていれば核酸、アルファベット(N・C)が付いていればタンパク質、と切り分けることです。どちらも「鎖の端」を表す言葉ですが、対象とする分子が違う、という点さえ押さえれば混乱しません。
4. 5’末端で起こること ─ 結合・キャップ・5’側の領域
ホスホジエステル結合とライゲーション
5’末端の主役はリン酸です。ヌクレオチドどうしは、一方の5′-リン酸と、次のヌクレオチドの3′-水酸基が結びつくことで鎖になります。これがホスホジエステル結合です[1][2]。DNAの断片どうしを酵素でつなぐ操作(ライゲーション)でも、この5′-リン酸と3′-OHの結合がつくられます。遺伝子検査や遺伝子クローニングなど、DNAを扱う技術の土台になっている反応です。
この仕組みを逆手にとった工夫もあります。DNA断片をつなぐとき、同じ断片の両端どうしがつながってしまう「自己連結」を防ぐため、分子生物学では5′-リン酸をあらかじめ酵素(ホスファターゼ)で外しておくことがあります。5′-リン酸が無くなるとホスホジエステル結合ができず、ライゲーションが起こらないためです。5’末端のリン酸が、鎖をつなぐうえでいかに重要な「のりしろ」かがよくわかる例です。
5’キャップ(キャッピング)とは
真核生物のメッセンジャーRNA(mRNA)の大半は、その5’末端に7-メチルグアノシン(m7G)という特別な構造が付きます。これを5’キャップ、その付加をキャッピングといいます。キャップは転写とほぼ同時に付けられ、キャップに結合するタンパク質を呼び寄せることで、mRNAのプロセシング・核外への輸送・キャップ依存の翻訳など、mRNAが機能するための多くの過程を助けます[3]。また、キャップに続く塩基の2′-O-メチル化は、細胞が自分のRNAとウイルス由来のRNAを見分ける(自然免疫)目印にもなります[3]。
キャップにはもう一つ、mRNAを分解から守るという大切な働きがあります。5’末端がむき出しの状態(5′-モノリン酸)になると、5’→3’方向にRNAを削っていくエキソヌクレアーゼによって速やかに分解されます。キャップが5’末端をふさぐことで、この分解を防いでいるのです[3]。なお、5’キャップやmRNAワクチンの製造といった話題は専門的で範囲が広いため、ここでは概要にとどめ、詳しくはmRNAの構造のページに譲ります。
5’非翻訳領域(5′-UTR)とプロモーター
mRNAの5’末端側には、5’非翻訳領域(5′-UTR)と呼ばれる領域があります。これは、キャップの位置から、タンパク質の設計図が始まる開始コドン(AUG)の直前までの部分で、翻訳はされないものの、翻訳の効率を調節する大切な役目を持っています。翻訳が始まるとき、リボソーム(正確には開始複合体)は5′-UTRを5’→3’方向に走査(スキャン)し、最初のAUGにたどり着いたところで翻訳を開始します。このAUGの周囲の並び(Kozak配列、代表的には(A/G)CCAUGGという並び)が、翻訳の始まりやすさを左右します[4]。開始複合体は5’側から走査し、適切な配列文脈にあるAUGを開始コドンとして選択します。最初のAUGが常に使われるとは限らず、Kozak配列が弱い場合のleaky scanningや上流ORF(uORF)などの例外もあります。そのため、5′-UTR内のAUGの位置と周囲の配列は、翻訳開始の効率や産生されるタンパク質に影響します。
💡 用語解説:5′-UTRと「5′-フランキング領域」は別もの
まぎらわしいのですが、mRNAの5′-UTR(転写されるが翻訳されない領域)と、遺伝子のさらに上流にある5′-フランキング領域(DNA上の、転写されない領域)は別ものです。5′-フランキング領域には、転写開始点の上流に位置するプロモーターなどの調節配列が含まれます。エンハンサーは上流に存在することもありますが、下流やイントロン内などに位置する場合もあります。「5’側」という言葉が、DNAの上流を指すのか、mRNAの非翻訳領域を指すのかで、意味が変わる点に注意してください。詳しくは5’非翻訳領域(5′-UTR)のページで解説しています。
5. 3’末端で起こること ─ ポリA尾部と3’側の領域
ポリA尾部(ポリアデニル化)
3’末端の側でも、mRNAには大切な加工が行われます。大半の真核生物のmRNAは、3’末端が特定の場所で切断されたあと、アデニン(A)が連続した「ポリA尾部(poly(A) tail)」が付け足されます。この過程をポリアデニル化といいます。目印となる配列(ポリアデニル化シグナル=AAUAAAと、その下流のGU(U)に富む配列)を複数のタンパク質が認識して切断し、そこにアデニンをつなげていきます[5][6]。ポリA尾部の長さは、およそ200前後(研究や条件によって幅があります)とされ、mRNAの安定性・翻訳・核外輸送に関わります[6]。
⚠ すべてのmRNAにポリA尾部があるわけではない
「mRNAの3’末端には必ずポリA尾部が付く」と思われがちですが、これには例外があります。細胞分裂に合わせてつくられる複製依存性ヒストンmRNAは、ポリA尾部を持たず、代わりに特徴的な幹ループ(ステムループ)構造で3’末端が終わります[6]。3’末端の加工は「必ずポリA」と一律に決めつけないことが大切です。
3’非翻訳領域(3′-UTR)
タンパク質の設計図(コード領域)が終止コドンで終わったあと、ポリA尾部が付く手前までの領域を3’非翻訳領域(3′-UTR)といいます。切断とポリA付加が起こる位置(ポリアデニル化部位)が、この3′-UTRの終わりを決めています[6]。3′-UTRは翻訳こそされませんが、mRNAの安定性や、細胞内のどこに運ばれるか(局在)、どれだけ翻訳されるかといった調節に関わる、重要な領域です。たとえば、マイクロRNA(miRNA)と呼ばれる小さなRNAは、多くの場合この3′-UTRに結びついて、標的となるmRNAの翻訳や分解を調節します。詳しくは3’非翻訳領域(3’UTR)のページで解説しています。
おもしろいことに、5’末端のキャップと3’末端のポリA尾部は、離れた両端どうしで協力してmRNAを支えています。ポリA尾部にはポリA結合タンパク質(PABP)が結びつき、これが5’キャップ側の因子と連携することで、mRNAの両端がぐるりとつながった環(ループ)のような状態になり、翻訳が効率よく進むと考えられています[6]。このように、5’末端と3’末端は「鎖の両端」というだけでなく、それぞれに固有の加工を持ち、ときに協力し合って、mRNAの安定性と翻訳を支えているのです。
🩺 院長コラム【「向き」を押さえると、遺伝子の話が一気にわかりやすくなる】
5’末端・3’末端は、一見すると受験の暗記事項のように見えるかもしれません。けれども、遺伝医学ではこの「向き」の感覚がとても役に立つと考えています。遺伝子の変化(バリアント)を表記するとき、塩基の位置は決まった向きにそって数えますし、転写・翻訳・スプライシングといった多くの現象も、すべて5’→3’という共通の向きの上で起こっています。
「5’から3’へ」という一本の軸を頭に入れておくと、複製・転写・翻訳・mRNAの加工といったバラバラに見える話が、同じ地図の上でつながって見えてきます。細部の丸暗記より、この向きの直感を持っておくことのほうが、ずっと長く役に立つと考えています。
6. よくある誤解
誤解①「3’→5’方向に新生鎖が合成される」
DNA・RNAの新生鎖の合成方向は5’→3′です。新しいヌクレオチドは伸長中の鎖の3′-OHに付加されます。一方、ポリメラーゼは鋳型鎖を3’→5’方向に読みます。この2つの向きを区別することが重要です。
誤解②「5’末端とN末端は同じもの」
5’/3’末端は核酸の端、N末端・C末端はタンパク質の端で、基準が違います。向きとしては対応しますが、別の分子の別の基準なので、等号で結ぶのは誤りです。
誤解③「’(プライム)はダッシュ」
「’」は糖の炭素番号を塩基環の番号と区別する記号で、英語ではプライム(prime)と読みます。5’は five-prime、3’は three-prime が正式で、割り算のダッシュとは無関係です。
誤解④「mRNAの3’末端は必ずポリA」
大半のmRNAはポリA尾部を持ちますが、複製依存性ヒストンmRNAのようにポリAを持たず幹ループで終わる例外もあります。「必ずポリA」とは限りません。
まとめ
5’末端・3’末端は、DNAやRNAという鎖の両端を、糖のどの炭素(5位か3位か)が端に来ているかで区別した呼び名です。5’末端にはリン酸、3’末端には水酸基(OH)が付いており、これが見分けの手がかりになります[1][2]。そして、新生鎖の合成方向は5’→3′で、塩基配列も通常この向きで表記します。翻訳ではmRNAを5’→3’に読みますが、ポリメラーゼが読む鋳型鎖は3’→5’です。「どちらを先に書くか」という意味では5’末端が先です。二本鎖は逆平行で、片方の5’末端と相手の3’末端が向かい合います。
さらに、5’末端にはキャップ(m7G)、3’末端にはポリA尾部という固有の加工が加わり、mRNAの安定性や翻訳を支えています[3][5][6]。核酸の5’/3’とタンパク質のN/C末端を混同しないこと、そして「必ずポリA」のように例外を無視して決めつけないことも、正確な理解のポイントです。遺伝子の変化(バリアント)を表記するときも、塩基の位置はこの5’→3’の向きにそって数えるのが基本で、向きの理解は遺伝情報を正しく読むうえでの土台になります。「5’から3’へ」という一本の向きを軸に置くと、複製・転写・翻訳・mRNAの加工が、同じ地図の上でつながって見えてきます。
遺伝子や遺伝子検査について、さらに知りたい方へ
ミネルバクリニックでは、遺伝や遺伝子検査に関する用語解説を数多く公開しています。遺伝子検査について詳しく見る
よくある質問(FAQ)
Q1. 5’末端と3’末端は、どっちが先ですか?
「先」にあたるのは5’末端です。DNAやRNAの合成も、mRNAの翻訳(読み取り)も、向きはいつも5’末端から3’末端(5’→3’)と決まっています。これは、酵素(ポリメラーゼ)が、すでにある鎖の3’末端の水酸基(3′-OH)にしか新しい部品をつなげられないためで、鎖はいつも5’側から始まって3’側へ伸びていきます。
Q2. 5’末端・3’末端とは何ですか?
DNAやRNAという鎖の、両端を区別するための呼び名です。骨格の中心にある五炭糖の炭素は1’〜5’と番号づけされており、5位炭素(C5’)が端に来る側を5’末端、3位炭素(C3’)が端に来る側を3’末端といいます。ふつう5’末端にはリン酸、3’末端には水酸基(OH)が付いています。
Q3. 5’末端と3’末端の違いは何ですか?どう見分けますか?
いちばんはっきりした違いは、末端に付いている基です。5’末端にはリン酸、3’末端には水酸基(OH)が付いています。図で見分けるときは、糖-リン酸の骨格をたどり、リン酸が露出している端が5’、水酸基が露出している端が3’です。二本鎖では逆平行なので、片方の5’末端と、もう片方の3’末端が向かい合っています。
Q4. なぜDNAは5’→3’方向にしか合成されないのですか?
DNAやRNAをつくるポリメラーゼが、既存の鎖の3’末端の水酸基(3′-OH)にだけ新しいヌクレオチドをつなげる仕組みだからです。反応のエネルギーは新しく加わる材料の側が持っており、この向きだからこそ、間違いを取り除いて付け直す校正も働きます。詳しい仕組み(岡崎フラグメントなど)は、DNA複製のページで解説しています。
Q5. 核酸の5’末端・3’末端と、タンパク質のN末端・C末端は同じですか?
同じではありません。5’/3’末端は核酸(DNA・RNA)の端の呼び名で、糖の炭素番号を基準にしています。N末端・C末端はタンパク質の端の呼び名で、アミノ酸のアミノ基・カルボキシ基を基準にしています。mRNAは5’→3’に読まれ、タンパク質はN末端→C末端に作られるため向きとしては対応しますが、別の分子の別の基準なので「5’末端=N末端」と等号で結ぶのは誤りです。
Q6. 5’キャップ(キャッピング)とは何ですか?
真核生物のmRNAの大半で、5’末端に付く7-メチルグアノシン(m7G)という構造とその付加のことです。キャップはmRNAのプロセシングや核外への輸送、キャップ依存の翻訳を助け、5’末端をふさぐことで分解からmRNAを守ります。5’キャップやmRNAワクチンの製造といった話題は範囲が広いため、詳しくはmRNAの構造のページで解説しています。
参考文献
- [1] Biochemistry, DNA Structure. StatPearls [Internet]. NCBI Bookshelf. [NCBI Bookshelf NBK538241]
- [2] Understanding biochemistry: structure and function of nucleic acids. [PMC6822018]
- [3] Ramanathan A, Robb GB, Chan SH. mRNA capping: biological functions and applications. Nucleic Acids Res. 2016;44(16):7511–7526. doi:10.1093/nar/gkw551. PMID:27317694. [PubMed]
- [4] von Loeffelholz O, et al. Translation initiation by the Kozak mRNA sequence is based on a conformational readout on the ribosome. Nat Commun. 2026;17(1):8467. doi:10.1038/s41467-026-73969-2. PMID:42420270. [PubMed]
- [5] Rodríguez-Molina JB, Turtola M. Birth of a poly(A) tail: mechanisms and control of mRNA polyadenylation. FEBS Open Bio. 2023;13(7):1140–1153. doi:10.1002/2211-5463.13528. PMID:36416579. [PubMed]
- [6] Boreikaitė V, Passmore LA. 3′-End Processing of Eukaryotic mRNA: Machinery, Regulation, and Impact on Gene Expression. Annu Rev Biochem. 2023;92:199–225. doi:10.1146/annurev-biochem-052521-012445. PMID:37001138. [PubMed]






