目次
「シークエンシング」という言葉は、フィギュアスケートやIT、音楽などさまざまな分野で使われますが、生命科学でいうDNAシークエンシング(DNA塩基配列決定)とは、DNAという「遺伝の書」に並んだ4種類の文字=塩基(A・T・G・C)の並び順を読み取ることを指します。この技術は、遺伝子診断・出生前検査・がんゲノム医療・感染症の変異株監視まで、現代医療の土台を支えています。この記事では、シークエンシングとは何か、「配列」や「シーケンサー」との違い、何がわかるのか、そしてサンガー法から次世代(NGS)・第3世代までの種類を、臨床遺伝専門医の視点でわかりやすく整理します。個々の手法の詳しい原理は、それぞれの専門ページへリンクでご案内します。
Q. DNAシークエンシングとは何ですか?まず結論だけ知りたいです
A. DNAシークエンシング(DNA塩基配列決定)とは、DNAを構成する4種類の塩基──アデニン(A)・チミン(T)・グアニン(G)・シトシン(C)──の並び順を読み取る技術のことです。「シークエンス(sequence)」が読み取る対象である配列そのものを指すのに対し、「シークエンシング(sequencing)」はそれを読み取る行為・技術、「シーケンサー」はそれを読み取る装置を指します。読み取った配列から、遺伝子や変異(バリアント)の同定、病気や病原体の解析などが可能になります。手法にはサンガー法・次世代シークエンサー(NGS)・第3世代(ロングリード)があります。
- ➤定義 → DNAの塩基(A・T・G・C)の並び順を決定すること
- ➤紛らわしい3語 → 配列=シークエンス/読む行為=シークエンシング/装置=シーケンサー
- ➤何がわかるか → 変異の同定・遺伝子診断・病原体や変異株の特定・系統/進化の解析
- ➤種類 → 第1世代サンガー法/第2世代NGS/第3世代ロングリード
- ➤医療との関わり → NIPT・遺伝子検査・全ゲノム/エクソーム検査の技術的な土台
🧬 DNAシークエンシングの基本情報
| 項目 | 内容 |
|---|---|
| 読み方・表記 | シークエンシング(sequencing)。DNA塩基配列決定ともいう。「シークエンス」「シーケンス」「シーケンシング」はいずれも同じ語の表記ゆれ |
| 何を決めるか | DNAを構成する4種の塩基 アデニン(A)・チミン(T)・グアニン(G)・シトシン(C) の並び順 |
| 対象 | 1つの遺伝子・遺伝子領域・染色体・ゲノム全体、RNA(多くのRNA-seqではcDNAを介して解析)など |
| 主な世代 | 第1世代=サンガー法/第2世代=次世代シークエンサー(NGS)/第3世代=ロングリード |
| 何がわかるか | 変異(バリアント)の同定、遺伝子診断、病原体・変異株の特定、系統・進化の解析 など |
| 医療との関わり | NIPT・遺伝子検査・全ゲノム/エクソーム検査を支える技術的な土台 |
※本記事は一般の方と遺伝診療に関わる方の両方に向けた用語・技術の解説です。特定の検査を勧めるものではありません。
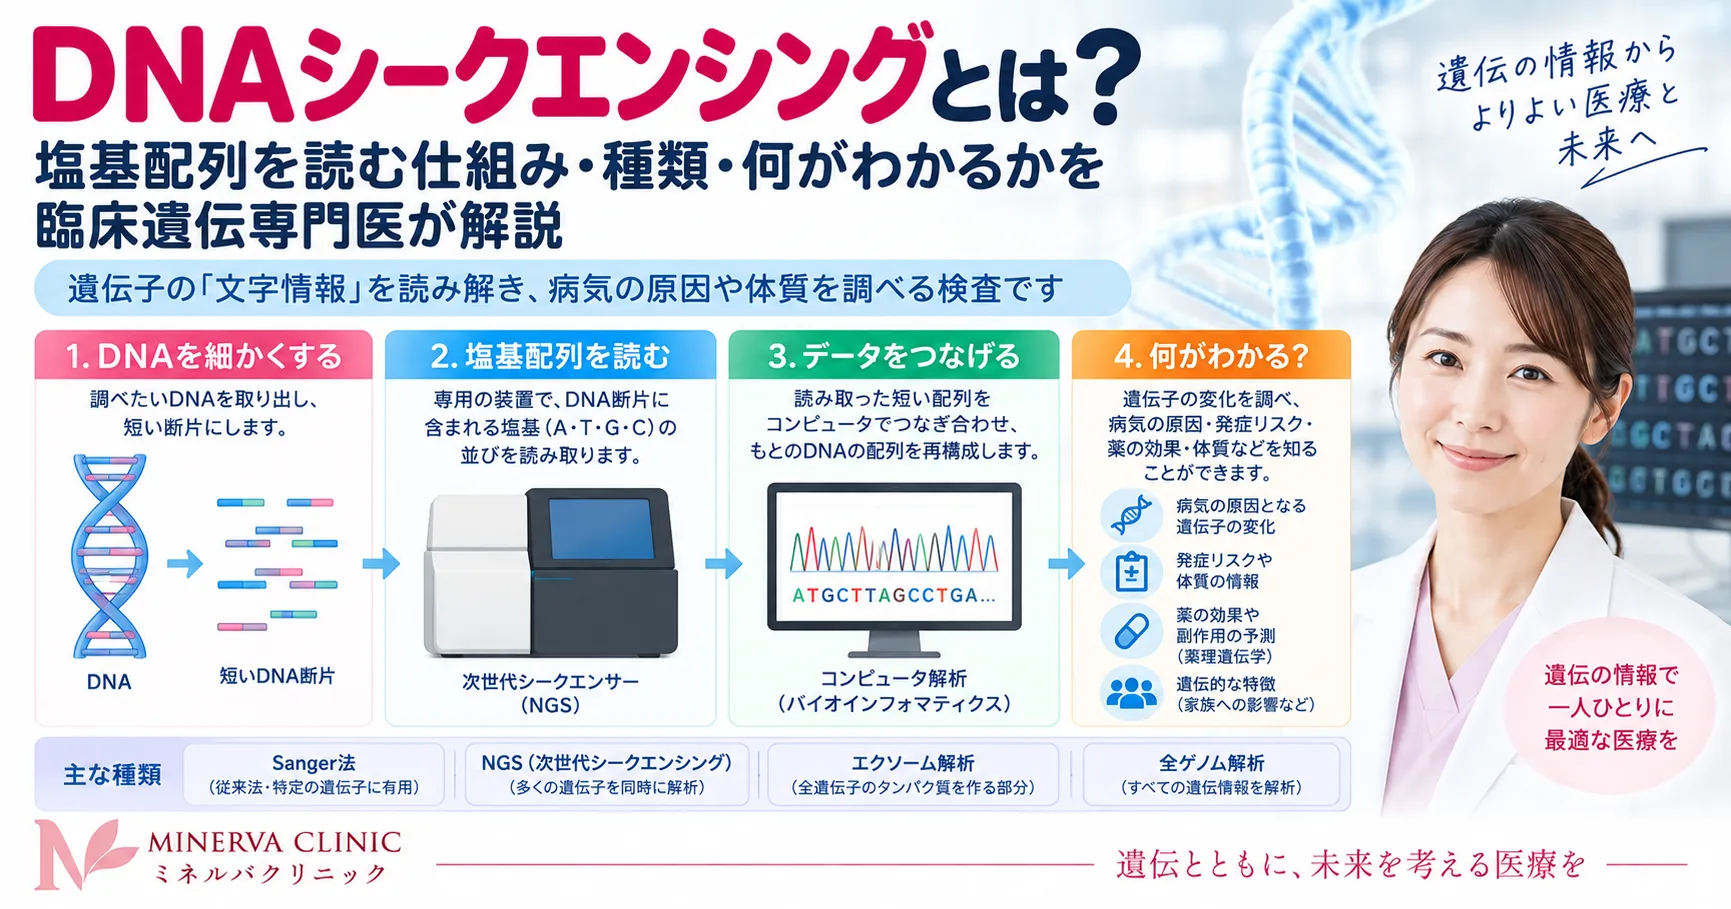
DNAシークエンシングはDNAのA・T・G・Cの並びを読み取る技術です。サンガー法、次世代シークエンサー(NGS)、ロングリードでは、一度に読める長さや処理量、得意な解析対象が異なります。
1. DNAシークエンシングとは ─ 「遺伝の書」を1文字ずつ読む
DNAシークエンシングとは、DNAを構成する塩基(A・T・G・C)の並び順を決定することです。わたしたちが文章を左から右へ文字をたどって読むのと同じように、DNAという「遺伝の書」に書かれた文字を1つずつ読み取っていく作業だと考えると分かりやすいでしょう。DNAの4つの文字は、アデニン(A)・チミン(T)・グアニン(G)・シトシン(C)という4種類の塩基で、この並び順そのものが、体をつくり動かすための情報になっています。
ヒトのゲノムは、1セット(片方の親由来の1コピー)で約30〜31億塩基対、両親由来の2セットを合わせると約62億塩基対にのぼります。この膨大な文字列を正確に読み取ることは、生命の設計図を理解するための最も基本的な作業のひとつです。読み取った配列は、遺伝子や変異の同定、系統や進化の解析、そして病気や病原体の解析など、生命科学・医学の幅広い場面で使われています。
DNAは、2本の鎖が向かい合った二重らせん構造をとっています。このとき、AはTと、GはCと、決まった相手どうしでペア(塩基対)をつくります。これを相補性といいます。相手が決まっているため、片方の鎖の並びが分かれば、もう片方の鎖の並びは自動的に決まります。シークエンシングとは、この片側の文字列を端から順に確定していく作業だと考えると分かりやすいでしょう。並び順そのものが情報を担っているからこそ、たった1文字の違いが、遺伝子の働きや病気の有無に関わってくることがあります。
💡 用語解説:塩基対と相補性
DNAの4つの文字(塩基)は、アデニン(A)はチミン(T)と、グアニン(G)はシトシン(C)と、必ず決まった組み合わせでペアをつくります。この「決まった相手とだけ結びつく性質」を相補性といい、遺伝情報を正確にコピーして次の世代へ伝えるための基本的な仕組みになっています。配列を読むさまざまな方法も、この相補性を利用して成り立っています。
「シークエンス」「シークエンシング」「シーケンサー」の違い
この分野では、よく似た3つの言葉が混同されがちです。意味を分けて理解しておくと、検索や説明のときに迷わなくなります。
💡 用語解説:紛らわしい3語の使い分け
シークエンス(sequence)=配列そのもの。読み取る対象、つまりA・T・G・Cの並びを指します。
シークエンシング(sequencing)=配列を読み取る「行為・技術」。この記事の主題です。
シーケンサー(sequencer)=配列を読み取る「装置」。実際に読み取る機械のことです。
なお「シークエンス」「シーケンス」「シークエンシング/シーケンシング」は、同じ英語をカタカナにする際の表記ゆれで、意味は同じです。
この3語のうち、配列そのもの(結果物としての塩基配列)については、塩基配列とはのページで詳しく解説しています。本記事は、その配列を「どうやって読むのか」という行為・技術の総論に絞って説明します。
2. なぜ塩基配列を「読む」のか ─ 決めるだけでは意味は分からない
塩基配列を決定しただけでは、その意味まで分かるわけではありません。ここは、多くの解説記事が省略しがちな、しかしとても大切なポイントです。ゲノムの配列決定は「解読」とよく混同されますが、配列を読むことと、その意味を理解することは別の段階なのです。
たとえるなら、ゲノムは句読点も大文字もなく、単語や文の区切りもなく、意味のない文字列も混じっている、なじみのない言語で書かれた非常に長い本のようなものです。文字を1つずつ読み取れたとしても、それだけでは「どこからどこまでが1つの遺伝子か」「その遺伝子が何をしているのか」まではすぐには分かりません。文章の意味が、文字の並びだけでなく、単語や文法によって決まるのと同じことです。
配列に書かれた情報が実際の働きになるまでには、DNAからRNAへ写し取られ(転写)、RNAのコドン(遺伝暗号)がアミノ酸へ翻訳され、タンパク質がつくられるという段階があります。ある配列が何を意味するのかは、こうしてできたタンパク質の機能や、遺伝子の発現の仕組みまで調べて初めて理解できます。つまり、「配列を読むこと」は入り口であって、ゴールではありません。ゲノムを「未来を言い当てる予言の書」のように語るのは行き過ぎで、配列は意味を読み解くための出発点だと考えるのが、遺伝医学の立場です。
もう少し具体的に見てみましょう。ゲノムには、タンパク質の設計図になる遺伝子(コード領域)だけでなく、遺伝子のオン・オフを調整する制御領域や、かつて「ジャンク(がらくた)」と呼ばれた、役割のよく分からない長い配列(非コード領域)も数多く含まれています。しかも、どこからどこまでが1つの遺伝子なのか、文章のような明確な区切りは、配列そのものには書かれていません。だからこそ、配列を読み終えた後に、「どこが遺伝子か」「それぞれが何をしているか」「どう調整されているか」を明らかにする解析が続きます。近年は、かつてジャンクとされた領域にも、遺伝子の働きを細かく調整する重要な役割があることが次々と分かってきています。シークエンシングは、こうした研究のすべての出発点を用意する、基盤の技術なのです。
3. DNAシークエンシングで何がわかるのか
DNAシークエンシングによって、遺伝子や変異(バリアント)の同定、遺伝子診断、病原体や変異株の特定、生物の系統・進化の解析などが可能になります。読み取った配列を、正常な参照配列や既知のデータと照らし合わせることで、「どこがどう違うのか」を明らかにできるからです。
医療の場面で特に重要なのは、遺伝子の変化(バリアント)を見つけられることです。ある遺伝子の配列に、多くの人と異なる並びが見つかれば、それが病気の原因になっているのか、体質の個性にとどまるのかを検討する材料になります。遺伝性疾患の診断、がんゲノム医療、そして出生前領域まで、配列を読む技術が診断の基盤を支えています。
医療以外でも、シークエンシングは大きな役割を果たします。感染症の分野では、ウイルスや細菌のゲノムを読むことで病原体を同定し、流行の広がりや変異株の出現を追跡できます。新型コロナウイルス(SARS-CoV-2)の変異株の監視でも、この技術が世界中で使われました。また、生物どうしの配列を比べることで、進化や系統の関係を明らかにする研究にも使われています。歴史をさかのぼると、1976年に最初の完全なRNAゲノム(バクテリオファージMS2)が決定され[5]、そして1977年に最初の完全なDNAゲノムが決定されました[1]。この歴史については次の章でも触れます。
ひとくちに「変化(バリアント)」といっても、その種類はさまざまです。1文字だけが別の文字に置き換わったもの(一塩基置換)、数文字が入り込んだり抜け落ちたりしたもの(挿入・欠失)、さらに広い範囲が入れ替わったり失われたりする大きな構造の変化まで、幅があります。どの種類の変化を得意に見つけられるかは、手法によって異なります。たとえば、短い断片を大量に読む方式は小さな変化の検出に強く、長く一気に読む方式は大きな構造の変化をとらえるのに向いています。見つかった変化が病気に関わるのか、それとも体質の個性にとどまるのかは、配列を読むだけでは決まらず、既知のデータベースやご家族の情報、その遺伝子の機能に関する知見と突き合わせて、総合的に評価されます。
さらに視野を広げれば、シークエンシングは医療にとどまらず、生物どうしの類縁関係をたどる系統・進化の研究、環境中の微生物をまとめて調べる解析、法医学など、生命に関わる幅広い分野で使われています。「DNAの文字を読む」という共通の技術が、基礎研究から日々の医療までを橋渡ししているのです。とはいえ本記事の主眼は医療・遺伝の文脈にありますので、以下では引き続き、臨床でどう役立つのかを中心に見ていきます。
⚠️ 検査で「わかること」を読むときの注意
シークエンシングで得られる検出率や精度は、対象とする集団・変異の種類・検査の設計によって変わります。集団のデータから得られた数字を、そのまま特定の個人の確率として当てはめることはできません。また、配列に変化が「ある」ことと、その変化が病気を「引き起こす」ことは同じではありません。相関と因果を区別し、見つかった変化の意味は専門的な評価のうえで慎重に判断する必要があります。
4. シークエンシングの種類 ─ サンガー法から第3世代まで
シークエンシングの手法は、大きく「世代」で整理できます。第1世代のサンガー法、第2世代の次世代シークエンサー(NGS)、第3世代のロングリードです。読み取りの化学の違いによって、一度に読める長さ・量・スピード・得意分野が変わります。まず全体像を見てみましょう。
第1世代:サンガー法
サンガー法は、1977年にフレデリック・サンガーが開発したジデオキシ法(鎖伸長停止法)をもとにした手法です。サンガーはこの功績により、1980年にノーベル化学賞を、核酸の塩基配列決定への貢献でウォルター・ギルバートと共同受賞しました(受賞のもう半分は、組換えDNA研究のポール・バーグに贈られました)[2]。最初に完全な塩基配列が決定されたゲノムも、このサンガーらによる大腸菌に感染するファージφX174(ファイ・エックス174)で、わずか5,386塩基・11遺伝子という小さなウイルスでした[1]。サンガー法は、DNAを合成していく途中で、狙った文字のところで伸長を止めた断片を多数つくり、その長さの違いから塩基を1文字ずつ読み解くという仕組みです。一度に読める量は多くありませんが、読み取りの正確さが高いため、今でも重要な役割を担っています。原理や精度の詳細はサンガー法のページをご覧ください。
第2世代:次世代シークエンサー(NGS)
2000年代半ばに登場した次世代シークエンサー(NGS)は、数百万から数億という膨大な数のDNA断片を同時並列に読み取ることを可能にしました[3]。1本ずつ読むサンガー法に比べ、桁違いのスピードと低コストを実現し、全エクソーム解析や全ゲノム解析を医療の現場に広げる原動力になりました。比較的短い断片を読む方式のためショートリードとも呼ばれます。
第3世代:ロングリード
第3世代は、1分子を直接読み取れる方式を含み、数kb〜数十kb以上の長い配列を連続して読み取れる技術です。ナノポア法では条件によって100kbを大きく超える超長鎖リードも得られます。ロングリードシーケンサーやナノポアシークエンサーが代表で、短い断片では読み解きにくい反復配列や大きな構造の変化、DNAメチル化などの情報まで、一度にとらえられるのが強みです。
この技術の進歩は、医療のあり方を大きく変えてきました。ヒトゲノム全体を初めて解読したヒトゲノム計画は、主にサンガー法を使い、巨額の費用と長い年月をかけて完了しました。その後にNGSが登場し、配列決定のコストとスピードが劇的に改善されたことで、かつては大規模な研究施設でしか行えなかった全エクソーム解析や全ゲノム解析が、患者さんの診療の現場で使えるようになりました。第3世代のロングリードは、そのうえで、これまで読み解きにくかった領域まで届く技術として位置づけられます。
📊 世代ごとの特徴(概観)
| 世代 | 代表的な呼び方 | 一度に読む長さ | 得意なこと |
|---|---|---|---|
| 第1世代 | サンガー法 | 短い(1本ずつ) | 高い正確さ。特定部位の確認 |
| 第2世代 | NGS(ショートリード) | 短い断片を大量に | 大量・高速。エクソームや全ゲノムの網羅解析 |
| 第3世代 | ロングリード(ナノポア等) | 非常に長い | 反復配列・大きな構造変化・修飾の把握 |
※各世代の精度・リード長・コストなどの具体的な数値は年々更新されます。詳細は上記の各専門ページをご参照ください。
なお、「シーケンサー(装置)」そのものの原理や種類、メーカー・価格といった話題は、主に研究・購買の観点で調べられるテーマです。本記事では深入りせず、塩基配列・シーケンサーや上記の各世代ページに譲ります。エクソームと全ゲノムの使い分けはエクソーム解析と全ゲノム解析の違い、全ゲノム解読そのものは全ゲノムシーケンス(WGS)とはで解説しています。
5. 配列を組み立てる ─ 断片を読んでつなぐという発想
多くのゲノムシークエンシングでは、ゲノムより短いDNA断片を多数読み、参照配列へ並べる(アライメント)か、重なりを利用してつなぎ直す(アセンブリ)ことで全体像を再構築します。ロングリードでは非常に長いDNA分子を読めるようになりましたが、ヒトゲノム全体を単一の連続リードとして一度に読み切るわけではありません。歴史的にも、初期の手法は一度に読める長さが限られ、ゲノムDNAを断片化してから解析する必要がありました。
この「切り刻んで読んで、つなぎ直す」作業は、巨大な生物学的ジグソーパズルを組み立てるようなものです。ヒトゲノム計画の時代には、ゲノムを大きな塊に分けて位置を特定してから読む方法(クローン・バイ・クローン法)や、細かく分割して一気に読んでから全体を再構築する方法(全ゲノムショットガン法)が使われました。現在は、こうした断片をどれだけ深く重ねて読むか=深度(カバレッジ)や、一度に読める長さ=リード長が、結果の質を大きく左右します。
💡 用語解説:リードとカバレッジ(深度)
一度に読み取れる連続した配列のかたまりをリード(read=読み取り断片)と呼びます。そして、ゲノムの同じ位置を何回重ねて読んだかを示すのがカバレッジ(深度)です。同じ場所を深く(何回も)読むほど、偶然の読み間違いと本当の変化とを見分けやすくなり、結果の信頼性が上がります。短い文章を何人もで手分けして読んで突き合わせると、写し間違いに気づきやすくなるのと似ています。
どれくらい細かい変化まで見えるか、どこまで深く読むかは、検査の目的によって設計されます。この「見える範囲・見える細かさ」については、ゲノム解析の解像度やRead depth(読み取り深度)解析で詳しく解説しています。
6. 臨床での位置づけ ─ 遺伝医療とシークエンシング
遺伝医療の現場では、シークエンシングの世代を目的に応じて使い分けます。1つの遺伝子や特定の部位を正確に調べたいときはサンガー法が、多くの遺伝子をまとめて調べる遺伝子パネルや、エクソーム・全ゲノムを網羅的に調べたいときはNGSが用いられます。NGSは診断率の向上に大きく貢献してきました。
調べる「範囲」も、目的に応じて選ばれます。あらかじめ選んだ特定の遺伝子群だけを調べる遺伝子パネル、タンパク質の設計図にあたる部分(エクソン)をまとめて調べる全エクソーム解析、そしてゲノム全体を調べる全ゲノム解析、という具合です。調べる範囲が広いほど、多くの情報が得られます。一方で、範囲が広がるほど、病気との関係がはっきりしない変化(意義不明のバリアント、VUS)も多く見つかるようになります。そのため、範囲を広げるほど、見つかった変化をどう解釈するかがいっそう重要になります。
ここで一つ、正確に理解しておきたい点があります。サンガー法は、NGSで見つかった変異を確認するための「直交的な手法(別の原理による確かめ)」として、今も広く使われています。ACMGの2021年改訂技術標準では、報告対象バリアントの直交確認は長く標準的に行われてきた一方、十分に検証された品質指標を用いる場合には、一部のSNVなどで確認を省略できる運用も認められています。検査室はバリアントの種類ごとに確認方針を定め、検証された方法がない場合は直交確認を継続することが求められます[4]。
💡 「必ずサンガーで確認する」わけではない
近年は、NGSの品質が一定の基準を満たす高信頼度の変異については、確認を省略できるとする考え方も広がっています。ACMGの2021年改訂技術標準では、各検査室がバリアントの種類と自施設の品質指標に基づいて確認方針を定めることが求められています。一方で、低頻度の変異(がんの体細胞変異、ミトコンドリアのヘテロプラスミー、生殖細胞系列のモザイクなど)では、なお別のアプローチが必要です[4]。つまり「サンガー=必ず確認に使う」ではなく、施設の方針・変異の種類・品質によって変わる、条件付きの運用だと理解するのが正確です。
遺伝子検査で配列を読むことは、あくまで判断材料の一つです。見つかった変化がご本人やご家族にとってどういう意味を持つのか、検査で何が分かり何が分からないのか、どのような選択肢があるのかを整理するのが、臨床遺伝専門医による遺伝カウンセリングの役割です。検査を受けるかどうかを含め、決めるのはご本人であり、私たちは中立の立場で判断材料を整理する立場に徹します。
シークエンシングは、多くのNIPT(新型出生前検査)や遺伝子検査、全ゲノム・全エクソーム検査で用いられる、重要な技術的基盤です。どの検査でも、DNAの文字を読み取り、その並びから意味のある情報を取り出すという原理は共通しています。だからこそ、シークエンシングという技術の全体像を知っておくことは、それぞれの検査で「何を読み、何が分かり、何は分からないのか」を理解するうえで助けになります。個々の検査の目的や範囲、限界については、各ページで詳しく解説しています。
🧬 遺伝子検査・出生前検査をお考えの方へ
シークエンシングは、多くのNIPTや遺伝子検査、全ゲノム/エクソーム検査を支える技術です。
検査で何が分かり何が分からないのか、結果の意味について知りたい方は、
臨床遺伝専門医が在籍するミネルバクリニックの各ページをご覧ください。
まとめ ─ 配列を読むことは、理解の入り口
DNAシークエンシングとは、DNAの塩基(A・T・G・C)の並び順を読み取る技術です。読み取る対象である「配列(シークエンス)」、読み取る「行為・技術(シークエンシング)」、読み取る「装置(シーケンサー)」を区別すると、この分野の言葉がすっきり整理できます。
サンガー法から次世代シークエンサー(NGS)、そして第3世代のロングリードへと技術は進歩し、遺伝子診断・がんゲノム医療・感染症の監視まで、現代医療の広い範囲を支えるようになりました。ただし、配列を読むことは理解の入り口であって、ゴールではありません。読み取った文字が何を意味するのかは、そこから先の解析と、臨床的な文脈のなかでの解釈があって初めて見えてきます。見つかった変化をどう読み解くか──そこに、臨床遺伝専門医と遺伝カウンセリングの役割があります。
技術は今も進歩を続けており、より速く、より長く、より正確に配列を読めるようになっています。しかし、どれだけ「読む力」が高まっても、読み取った文字の意味を読み解き、一人ひとりの状況に照らして判断するのは人の役割です。DNAシークエンシングは、その判断を支える確かな土台として、これからも遺伝医療の中心にあり続けるでしょう。
よくある質問(FAQ)
Q1. シークエンシングとはどういう意味ですか?
DNAシークエンシング(DNA塩基配列決定)とは、DNAを構成する4種類の塩基──アデニン(A)・チミン(T)・グアニン(G)・シトシン(C)──の並び順を読み取る技術のことです。生命科学以外にも「シークエンス(連続・順序)」という言葉はさまざまな分野で使われますが、遺伝学の文脈では「DNAの文字を読む」ことを指します。
Q2. シークエンス・シークエンシング・シーケンサーの違いは何ですか?
「シークエンス(sequence)」は読み取る対象である配列そのもの、「シークエンシング(sequencing)」はそれを読み取る行為・技術、「シーケンサー(sequencer)」はそれを読み取る装置を指します。なお「シークエンス/シーケンス」「シークエンシング/シーケンシング」は同じ英語の表記ゆれで、意味は同じです。
Q3. DNAシークエンシングで何がわかりますか?
読み取った配列を参照配列や既知のデータと照らし合わせることで、遺伝子や変異(バリアント)の同定、遺伝子診断、病原体や変異株の特定、生物の系統・進化の解析などが可能になります。ただし、検出率や精度は集団や検査設計によって変わり、集団のデータをそのまま個人の確率に当てはめることはできません。また、配列に変化が「ある」ことと、それが病気を「引き起こす」ことは別で、意味は専門的な評価のうえで判断されます。
Q4. サンガー法と次世代シークエンシング(NGS)の違いは何ですか?
サンガー法(第1世代)は一度に読む量は多くありませんが読み取りの正確さが高く、特定部位の確認に向いています。次世代シークエンサー(NGS・第2世代)は、膨大な数のDNA断片を同時並列に読むことで、大量・高速・低コストの網羅的な解析を可能にしました。両者は用途に応じて使い分けられ、NGSで見つけた変異をサンガー法で確認することもあります。原理や精度の詳細はサンガー法・NGSの各ページで解説しています。
Q5. RNAシークエンシングとは何ですか?
RNAシークエンシング(RNA-seq)は、細胞がどの遺伝子をどれくらい使っているか(発現)などを、RNAをもとに調べる手法です。多くのRNA-seqでは、RNAをいったんcDNA(相補的DNA)に変換してから配列を読みます。なお、ナノポア法にはRNA分子を直接読む方式もあります。なお、歴史的には1976年にバクテリオファージMS2の完全なRNAゲノム配列が報告されています[5]。DNAシークエンシングと原理の土台は共通しますが、対象がRNAである点が異なります。
参考文献
- [1] Sanger F, Air GM, Barrell BG, et al. Nucleotide sequence of bacteriophage φX174 DNA. Nature. 1977;265:687–695. [DOI:10.1038/265687a0]
- [2] The Nobel Prize in Chemistry 1980. NobelPrize.org(Walter Gilbert・Frederick Sanger/Paul Berg). [nobelprize.org]
- [3] Behjati S, Tarpey PS. What is next generation sequencing? Arch Dis Child Educ Pract Ed. 2013;98:236–238. [DOI:10.1136/archdischild-2013-304340]
- [4] Rehder C, Bean LJH, Bick D, et al. Next-generation sequencing for constitutional variants in the clinical laboratory, 2021 revision: a technical standard of the American College of Medical Genetics and Genomics (ACMG). Genet Med. 2021;23:1399–1415. [DOI:10.1038/s41436-021-01139-4]
- [5] Fiers W, Contreras R, Duerinck F, et al. Complete nucleotide sequence of bacteriophage MS2 RNA: primary and secondary structure of the replicase gene. Nature. 1976;260:500–507. [DOI:10.1038/260500a0]