

目次

📍 クイックナビゲーション
アラインメント(アライメント、alignment)とは、DNA・RNA・タンパク質の配列を、対応する塩基やアミノ酸が同じ列に来るように並べて比べる解析、またはその並べた結果のことです。並べることで、どこが一致し、どこが置き換わり、どこに挿入・欠失があるのかが一目でわかります。この操作はバイオインフォマティクス(生命情報科学)の最も基本的な手法であり、進化の研究だけでなく、次世代シークエンサーを使った遺伝学的検査や、遺伝子の変化(バリアント)の解釈にも欠かせません。この記事では、アラインメントの意味と種類、代表的なツール、そして遺伝子検査でアラインメントがどう使われ、どこで間違えやすいのかを、臨床遺伝専門医の視点から解説します。
Q. アラインメントとは何ですか?まず結論だけ知りたいです
A. アラインメントとは、2本以上の塩基配列やアミノ酸配列を、似ている部分が縦にそろうように並べて比べる解析です。並べた結果から、一致している位置、置き換わった位置(ミスマッチ)、片方にだけ存在する位置(ギャップ)を読み取り、配列どうしの類似性を数値で評価します。遺伝子検査では、読み取った大量のDNA断片をヒトの参照ゲノム上に位置づける工程(マッピング)でアラインメント計算が使われます。「アライメント」と「アラインメント」は同じ英語 alignment の表記の違いで、意味は変わりません。
- ➤意味 → 配列を並べて一致・ミスマッチ・ギャップを明らかにする操作とその結果
- ➤評価のしかた → 一致・置換・ギャップに点数を与え、合計点が最大になる並べ方を選ぶ
- ➤種類 → 2本を並べるペアワイズと3本以上の多重配列アラインメント、全体を並べるグローバルと部分を並べるローカル
- ➤遺伝子検査との関係 → NGSのリードを参照ゲノムに並べるマッピングが解析の出発点。偽遺伝子など似た配列の多い領域では誤りが起こりうる
- ➤バリアント解釈 → 多重配列アラインメントで「進化の中で保存された位置」を調べ、判断材料の一つにする
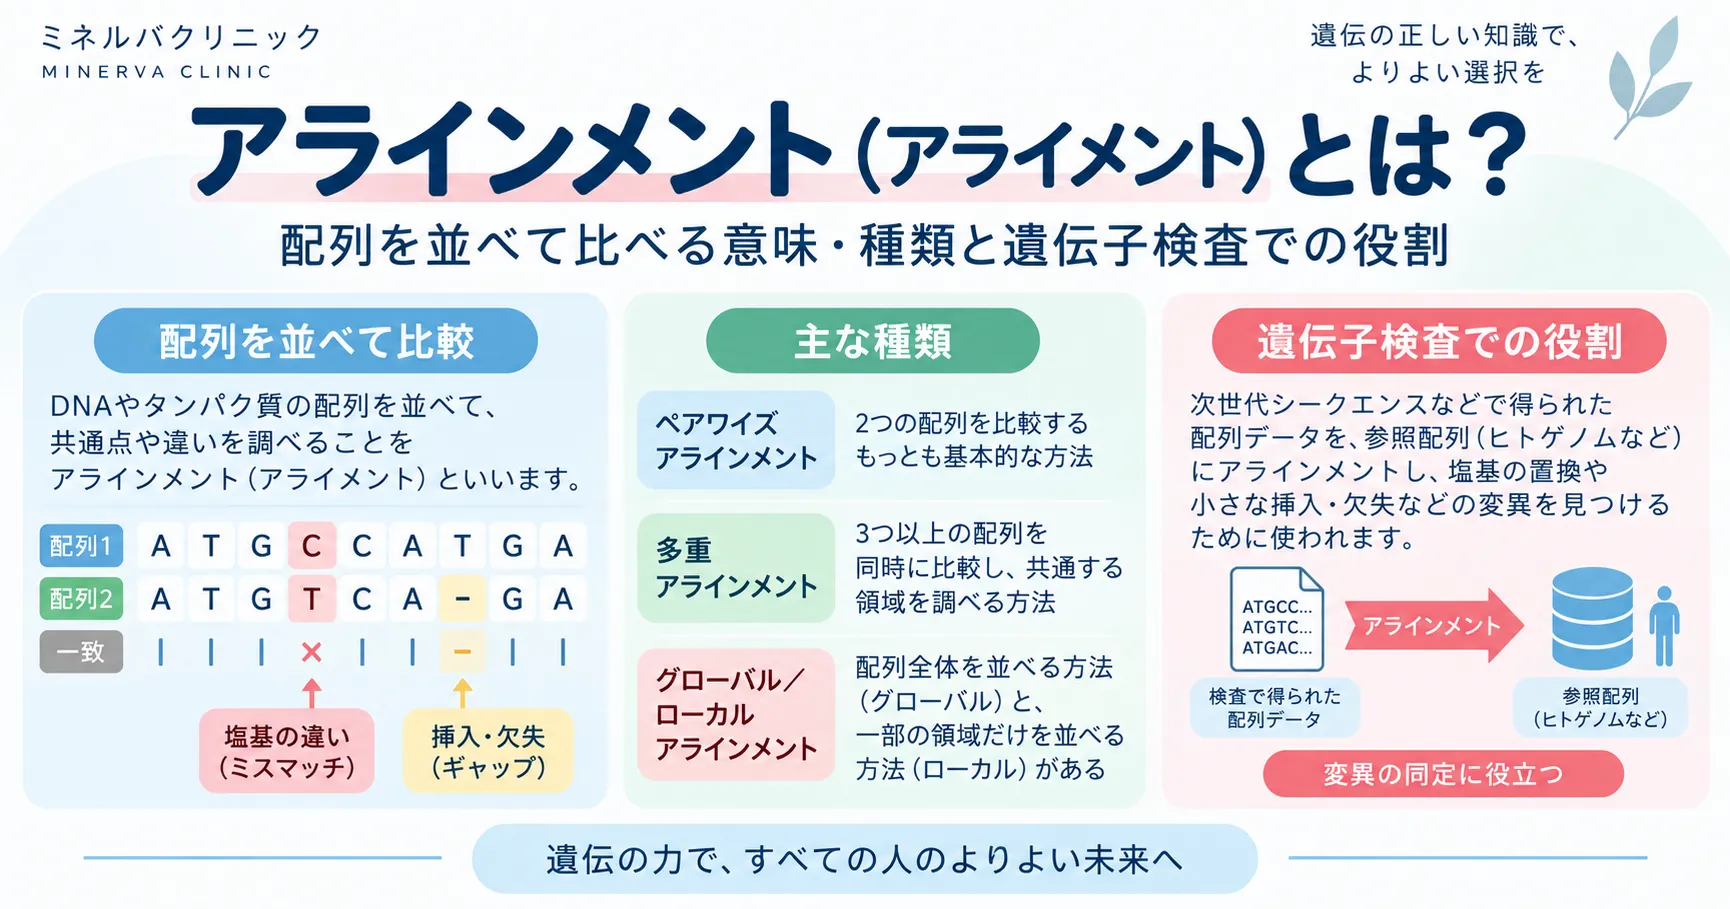
🧬 アラインメントの基本情報
| 項目 | 内容 |
|---|---|
| 表記・英語名 | アラインメント/アライメント(alignment)。配列アラインメント、シーケンスアラインメント(sequence alignment)とも呼ぶ |
| 対象 | DNA・RNAの塩基配列、タンパク質のアミノ酸配列(立体構造どうしを比べる構造アラインメントもある) |
| 読み取れること | 一致・ミスマッチ(置換)・ギャップ(挿入・欠失)の位置と、配列全体の類似性 |
| 主な種類 | ペアワイズ/多重配列アラインメント(MSA)、グローバル(大域)/ローカル(局所) |
| 代表的なツール | BLAST、ClustalW/Clustal Omega、MAFFT、MUSCLE、T-Coffee、BWA(NGSのリードマッピング)など |
| 医療との関わり | 遺伝学的検査の解析(リードのマッピング)、バリアントの病原性評価(保存性の確認)、NIPTの解析など |
※本記事は生物学・ゲノム医療での「アラインメント」を扱う用語解説です。特定の検査を勧めるものではありません。
💡 ほかの分野の「アラインメント」について
「アラインメント」はもともと「整列・調整・一致させること」を意味する英単語で、分野によって指すものが異なります。AI分野では人間の意図に沿わせる「AIアラインメント」、ビジネスでは部門間の方向性をそろえること、自動車では車輪の角度調整、整形外科では骨や関節の並び方を指します。このページでは、生物学・遺伝医療で使う「配列のアラインメント」について解説します。
1. アラインメント(アライメント)とは?配列を並べて比べる解析
アラインメントとは、配列どうしの「どこが対応しているか」を決めてから比べるための操作です。配列を単純に左端から重ねただけでは、途中に1文字の挿入があるだけで、それ以降がすべてずれて「まったく似ていない」ように見えてしまいます。アラインメントでは、必要な場所にすき間(ギャップ)を入れながら、対応する文字が同じ列に来るように並べ直します。
一言でいうと
アラインメントとは、2本以上の塩基配列やアミノ酸配列を、似ている部分が縦にそろうように並べ、一致・不一致・挿入欠失を明らかにする解析です。1970年にニードルマン(Needleman)とウンシュ(Wunsch)が、2つのタンパク質のアミノ酸配列の類似性を計算機で求める方法を発表し、そこから配列どうしに有意な類縁関係があるかを判断し、進化の経過をたどる、という考え方が示されました[1]。現在の配列解析の多くは、この「並べて、点数をつけて、比べる」という枠組みの上に成り立っています。
「アライメント」と「アラインメント」の違い
「アライメント」と「アラインメント」は、どちらも英語の alignment をカタカナにしたもので、意味は同じです。どちらかが誤りということはなく、分野や書き手によって使い分けられています。生命情報科学の教科書や公的なデータベースの解説では「アラインメント」が多く、IT分野や自動車分野では「アライメント」がよく使われる傾向があります。検索するときは両方の表記を試すと、目的の情報にたどり着きやすくなります。
相同性・類似性・同一性との関係
アラインメントとよく一緒に出てくるのが「相同性」「類似性」「同一性」という言葉です。この3つは日常的に混同されやすいのですが、意味は異なります。1987年に分子進化の研究者11名がCell誌に連名で出した書簡は、相同性(homology)とは「共通の進化的起源をもつこと」を指し、配列は相同であるかないかのどちらかであって、「◯%の相同性」という言い方は成り立たないと整理しました[2]。この定義は国際生化学分子生物学連合(IUBMB)の命名委員会も支持しています[3]。
🔍 相同性・類似性・同一性の違い
| 用語 | 意味 | 性質 |
|---|---|---|
| 相同性(homology) | 2つの配列が共通の祖先配列に由来すること | 「ある/ない」の質的な概念。%では表さない |
| 同一性(identity) | アラインメントした位置のうち、まったく同じ文字が並んでいる割合 | 量的な指標(%で表す) |
| 類似性(similarity) | 同じ文字に加え、性質の似たアミノ酸どうしの置換も「似ている」と数えた度合い | 量的な指標(%やスコアで表す) |
※同一性や類似性はアラインメントを行ってはじめて計算できます。高い類似性は相同性を推定する根拠になりますが、相同な配列でも長い進化の中で類似性がほとんど失われていることがあります[2]。
つまり、アラインメントは「どれくらい似ているか(類似性・同一性)」を測る道具であり、その結果から「同じ祖先に由来するか(相同性)」を推定する、という二段階の関係にあります。「相同性◯%」という慣用的な表現は、厳密には同一性や類似性を指していると読み替えるのが正確です。
2. 図でわかるアラインメント:一致・ミスマッチ・ギャップ
アラインメントの結果は、「一致」「ミスマッチ」「ギャップ」の3種類の関係で読み解きます。まず実際に2本の配列を並べた例を見て、それぞれが何を意味するのかを確認しましょう。
2本の配列を実際に並べた例
下の図は、10塩基の配列1と9塩基の配列2を並べた例です。配列2の5番目に「−」(ギャップ)を入れることで、前半の4塩基と後半の5塩基がきれいに対応します。縦線は同じ塩基が並んでいる位置(一致)、×は異なる塩基が並んでいる位置(ミスマッチ)を示しています。

もしギャップを入れずに左端からそのまま重ねると、5番目以降がすべて1文字ずつずれてしまい、実際にはよく似た配列なのに、ほとんど一致しないように見えます。正しくギャップを入れられるかどうかが、アラインメントの質を大きく左右します。1981年にスミス(Smith)とウォーターマン(Waterman)が発表した方法の原著でも、ミスマッチ1か所と内部の欠失を含む短いRNA配列の例が示され、欠失を厳密な計算で扱えることが強調されています[4]。
ミスマッチは主に置換、ギャップは主に挿入・欠失の痕跡
進化的に関連する配列を比べる場合、ミスマッチは主に塩基やアミノ酸の置換を、ギャップは主に挿入または欠失を反映していると解釈します。BLASTの原著論文も、動的計画法による配列比較を「挿入・欠失・置換にそれぞれコストを与え、最も少ないコストの変異の組み合わせに相当する並べ方を求めるもの」と説明しています[5]。
この考え方は、遺伝医療でいうバリアントの種類とそのまま対応しています。1塩基の置き換わりは一塩基バリアント(SNV)として、塩基の挿入や欠失は、その長さが3の倍数でなければ読み枠がずれるフレームシフト変異として現れます。ただし、ミスマッチやギャップが必ず生物学的な変化を意味するとは限りません。次世代シークエンサーのデータでは、読み取りの誤り(シークエンスエラー)や、配列を並べる位置そのものを間違えた「誤アラインメント」が、見かけ上のミスマッチやギャップを生むことがあります。この点は第5章で詳しく扱います。
スコアで「最もよい並べ方」を選ぶ
同じ2本の配列でも、ギャップを入れる位置によって並べ方は何通りもあります。そこで、一致・置換・ギャップにそれぞれ点数を与え、合計点(アラインメントスコア)が最も高くなる並べ方を「最適なアラインメント」とします。たとえば「一致+1点、ミスマッチ−1点、ギャップ−2点」と決めると、上の図の並べ方は、一致8か所(+8)、ミスマッチ1か所(−1)、ギャップ1か所(−2)で合計5点になります。これは説明のための仮の点数で、実際の値はツールや目的によって異なります。
アミノ酸配列では、置換の点数を一律にせず、置換行列(スコア行列)という表を使います。置換行列では、進化の中で互いに置換されやすいアミノ酸の組み合わせには高いスコアを、置換されにくい組み合わせには低いスコアを与えます。広く使われているBLOSUM行列は、500以上の関連タンパク質グループに属する約2000のブロック(ギャップを含まない整列済み断片)から作られ、それまで主流だったDayhoffモデルに基づく行列(PAM)より整列や検索の性能を改善しました[6]。日本のDNAデータバンク(DDBJ)の解説によると、BLASTはアミノ酸配列の比較にBLOSUM62を用い、DNAの比較では一致に+5点、不一致に−4点を与えています[7]。
ギャップを無制限に入れれば見かけの一致はいくらでも増やせるため、ギャップには減点(ギャップペナルティ)を与えます。点数の決め方は結果を左右するため、同じ配列でも設定によって並べ方が変わりうることは重要な限界です。
3. アラインメントの種類
アラインメントは、「何本の配列を並べるか」と「配列のどの範囲を並べるか」の2つの軸で分類されます。前者がペアワイズと多重配列アラインメント、後者がグローバルとローカルです。
📊 アラインメントの主な分類
| 分類 | 内容 | 主な用途・代表的な方法 |
|---|---|---|
| ペアワイズアラインメント | 2本の配列を並べる | データベース検索(BLAST)、2つの遺伝子の比較 |
| 多重配列アラインメント(MSA) | 3本以上の配列を同時に並べる | 保存領域の特定、系統樹の作成(ClustalW、MAFFT、MUSCLE など) |
| グローバル(大域)アラインメント | 配列の端から端までを並べる | 全体がよく似た、長さの近い配列の比較(Needleman-Wunsch法) |
| ローカル(局所)アラインメント | 最も似ている部分だけを取り出して並べる | 一部だけ共通するドメインやモチーフの探索(Smith-Waterman法) |
| 構造アラインメント | タンパク質の立体構造どうしを重ね合わせる | 配列が似ていなくても形が似ているタンパク質の比較 |
ペアワイズアラインメントと多重配列アラインメント(MSA)
ペアワイズアラインメントは2本の配列を並べる方法、多重配列アラインメント(multiple sequence alignment:MSA)は3本以上の配列を同時に並べ、どの位置が共通して保たれているかを一覧できるようにする方法です。MSAは、1本ずつ比べるだけではわからない「多くの配列に共通する特徴」を浮かび上がらせます。ClustalWの原著論文は、MSAの用途として、タンパク質ファミリーに特徴的なパターンの発見、新しい配列と既知のファミリーとの相同性の検出、タンパク質の二次構造・三次構造の予測、PCRプライマーの設計、そして分子進化解析の前段階を挙げています[8]。
一方で、MSAには大きな計算上の壁があります。N本の配列を理論上最適に並べようとすると、計算量が配列の本数に応じて爆発的に増えるため、少数の配列でも厳密な計算は現実的ではありません[9]。そこで多くのツールは、似た配列どうしから順に並べて最後に全体をまとめるプログレッシブ法などの近似的な方法を使います。MSAの結果は「唯一の正解」ではなく、方法や設定によって細部が変わりうる推定だという点は、結果を読むうえで重要です。
グローバル(大域)とローカル(局所)
グローバルアラインメントは配列全体を端から端まで並べる方法、ローカルアラインメントは配列の中で最も似ている部分だけを取り出して並べる方法です。グローバルアラインメントの代表がNeedleman-Wunsch法で、2つの配列の全ての組み合わせを二次元の表で表し、表の中を通る経路の中から合計点が最大になるものを選びます[1]。ローカルアラインメントの代表がSmith-Waterman法で、長い配列の中から、最も似ている部分配列の組み合わせを数学的に厳密に見つけ出します[4]。
長さが近く全体がよく似ている配列にはグローバル、一部だけに共通のドメインをもつ配列や、短い配列を長い配列の中から探す場合にはローカルが向いています。BLASTも局所的な類似性を探す方法です[5]。
構造アラインメント
アミノ酸配列ではなく、タンパク質の立体構造どうしを重ね合わせて比べる方法を構造アラインメントといいます。進化の中でアミノ酸配列の類似性がほとんど失われていても、立体構造は保たれていることがあるため、配列だけでは見つからない遠い類縁関係の手がかりになります。多重配列アラインメントのツールの中にも、構造の重ね合わせの情報を取り込んで精度を高められるものがあります[10]。
4. アラインメントのやり方と代表的なツール
アラインメントは、配列を用意し、目的に合ったツールを選び、点数の条件を決めて実行し、結果を読む、という流れで行います。現在はウェブ上で公開されている無料のツールも多く、研究者でなくても試すことができます。アラインメントは、生物学的なデータを計算機で解析するバイオインフォマティクスの最も基本的な操作の一つです。
基本の流れ
第一に、比べたい配列をFASTA形式などの決まった書式で用意します。第二に、目的に応じてツールを選びます。1本の配列に似たものをデータベースから探したいならBLAST、手元の3本以上の配列を並べたいならClustal OmegaやMAFFTなどの多重配列アラインメントツールが代表的です。第三に、置換行列やギャップペナルティなどの条件を決めます(初めは標準設定で構いませんが、設定によって結果が変わりうる点は意識しておきます)。最後に、出力された並べ方とスコアを読み取ります。
代表的なツール一覧
🛠️ 代表的なアラインメントツール
| ツール | 種類 | 特徴 |
|---|---|---|
| BLAST | ペアワイズ(データベース検索) | 局所的な類似性を高速に近似して探す方法。発表当時、同程度の感度をもつ既存の方法より1桁以上速かった[5] |
| ClustalW | 多重配列アラインメント | プログレッシブ法の感度を、配列ごとの重み付けや位置に応じたギャップペナルティなどで改善した古典的ツール[8] |
| Clustal Omega | 多重配列アラインメント | Clustalシリーズの新しい版。数千本規模のタンパク質配列を短時間で高い精度で並べられる[9] |
| MAFFT | 多重配列アラインメント | 高速フーリエ変換(FFT)を使って相同な領域をすばやく見つける。高速なプログレッシブ法と、精度を高める反復改善法を選べる[11] |
| MUSCLE | 多重配列アラインメント | k-mer(短い部分配列)の数え上げによる距離推定、対数期待値(log-expectation)スコアによる整列、木構造に基づく分割による改良の3段階で整列する[12] |
| T-Coffee | 多重配列アラインメント | すべての配列ペアの局所・大域アラインメントをあらかじめ「ライブラリ」として集め、それを手がかりに整列する。他のツールの結果や構造情報も組み合わせられる[10] |
| MEGA | 分子進化解析の統合ソフト | アラインメント結果をもとにした系統樹の推定などに広く使われる。2024年に第12版が公開された[13] |
| BWA など | リードマッピング | NGSの大量の短いリードを、ヒトゲノムのような長い参照配列に、ミスマッチやギャップを許しながら並べる[14] |
※ツールの優劣は、配列の本数・長さ・似ている程度によって変わります。どれが常に最良ということはありません。
結果の見方(記号・色・E値)
多重配列アラインメントの出力では、各列の下に、すべての配列で同じ文字がそろった列や、性質の似たアミノ酸がそろった列を示す記号が付くのが一般的です。表示ソフトによっては、アミノ酸を性質(疎水性、電荷など)ごとに色分けし、保存された領域が色の帯として目で見てわかるようになっています。記号や配色の決まりはツールごとに異なるため、凡例を確認して読みます。
BLASTなどのデータベース検索で最も重要な指標がE値(Expect value)です。E値とは、同じかそれ以上のスコアをもつ一致が、偶然だけで何件見つかると期待されるかを表す数値で、小さいほど偶然では説明しにくい一致であることを示します。米国国立医学図書館(NLM)の教材は、E値はスコアが高くなるほど指数関数的に小さくなり、検索するデータベースの大きさに比例して大きくなると説明しています[15]。E値は確率そのものではなく、データベースの大きさや配列の長さで変わるため、「E値がいくつ以下なら必ず相同」という絶対的な基準はありません。一致した長さや同一性の割合と合わせて総合的に判断します。
5. 遺伝子検査とアラインメント:NGSのリードマッピング
遺伝子検査では、読み取った大量のDNA断片をヒトの参照ゲノム上に位置づける「マッピング」が解析の出発点であり、その位置で塩基ごとの対応を決めるためにアラインメント計算が使われます。この工程の正確さが、その後に見つかるバリアントの信頼性を左右します。
マッピングとアラインメントの違い
次世代シークエンサー(NGS)は、ゲノムを短い断片に分けて一度に大量に読み取ります。1本1本の読み取り結果をリード(read)と呼びます。マッピングとは、それぞれのリードが参照ゲノム(ヒトの標準的なゲノム配列)のどこに由来するかを決める作業です。多くの解析では、その候補位置に対して塩基ごとの対応関係を決めるアラインメントを伴います。NGSの分野では両者は密接に結びついており、「リードマッピング」「リードアラインメント」が近い意味で使われることもありますが、厳密にはマッピングは参照上の位置決定、アラインメントは配列どうしの対応付けを指します。代表的なツールであるBWAの原著論文は、短いリードをヒトゲノムのような大きな参照配列に、ミスマッチやギャップを許しながら並べ、その結果を標準的なSAM形式で出力して、バリアントの検出などの後工程に渡すと説明しています[14]。
通常の配列アラインメントとの違いは、規模と目的です。数本の配列を丁寧に比べる通常のアラインメントに対し、マッピングでは膨大な数のリードを、約30億塩基対のヒトゲノムの中から素早く位置づける必要があります。BWAの原著論文の時点でも、1回の測定で5000万〜2億本のリードが得られると記載されています[14]。BWAは、Burrows-Wheeler変換という索引の技術を使って、この作業を高速化しています[14]。
遺伝学的検査の解析の流れ
NGSを使った遺伝学的検査の解析は、一般に次の順序で進みます。
まずDNAシークエンシングで塩基配列を読み取り、得られたリードを参照ゲノムに並べます。次に、並べたリードと参照配列を比べて、参照配列と異なる位置(バリアント)を拾い出します。最後に、見つかったバリアントが病気と関係するかどうかを、米国臨床遺伝・ゲノム学会(ACMG)と分子病理学会(AMP)の基準などに沿って、病的・病的の可能性が高い・意義不明・良性の可能性が高い・良性の5段階に分類します[16]。全エクソーム検査(WES)や遺伝子パネル検査も、この流れの上に成り立っています。マッピングの段階で誤りがあると、その後の工程をどれだけ丁寧に行っても、存在しないバリアントを拾ったり(偽陽性)、実在するバリアントを見逃したり(偽陰性)することにつながります。
アラインメントが難しい領域:偽遺伝子と相同性の高い領域
ゲノムの中に、ほとんど同じ配列が2か所以上ある領域では、短いリードがどちらに由来するのかを決められず、マッピングの誤りが起こりやすくなります。代表的なのが、機能する遺伝子とよく似た配列をもつ偽遺伝子や、長い配列が重複した低コピーリピート(LCR)などの領域です。2016年の報告は、相同性の高い領域が短いリードを使うNGSにとって大きな課題であり続け、診断上の偽陽性・偽陰性の原因になりうるとして、解析が難しい遺伝子やエクソンを全エクソーム規模で一覧にした資料を作成しました[17]。
臨床的に重要な遺伝子の中にも、こうした問題を抱えるものがあります。2021年の研究は、CYP21A2、GBA、HBA1/HBA2、PMS2、SMN1を、相同性による誤アラインメントの問題を抱える臨床上重要な遺伝子として取り上げています[18]。これらはそれぞれ、先天性副腎過形成、ゴーシェ病、αサラセミア、リンチ症候群、脊髄性筋萎縮症(SMA)に関わる遺伝子です。
SMAの原因遺伝子SMN1は、そのわかりやすい例です。SMN1と近接するSMN2は非常によく似たパラログで、どちらも同じアミノ酸配列のSMNタンパク質をコードします。Lorsonらの報告では、解析したSMN1・SMN2配列間の5塩基の差のうち、エクソン7にある1塩基の違い(C→T)が、SMN2でエクソン7が読み飛ばされやすくなる原因であることが示されています[19]。これほど似ていると、短いリードがSMN1とSMN2のどちらに由来するのかを判別することは容易ではありません。
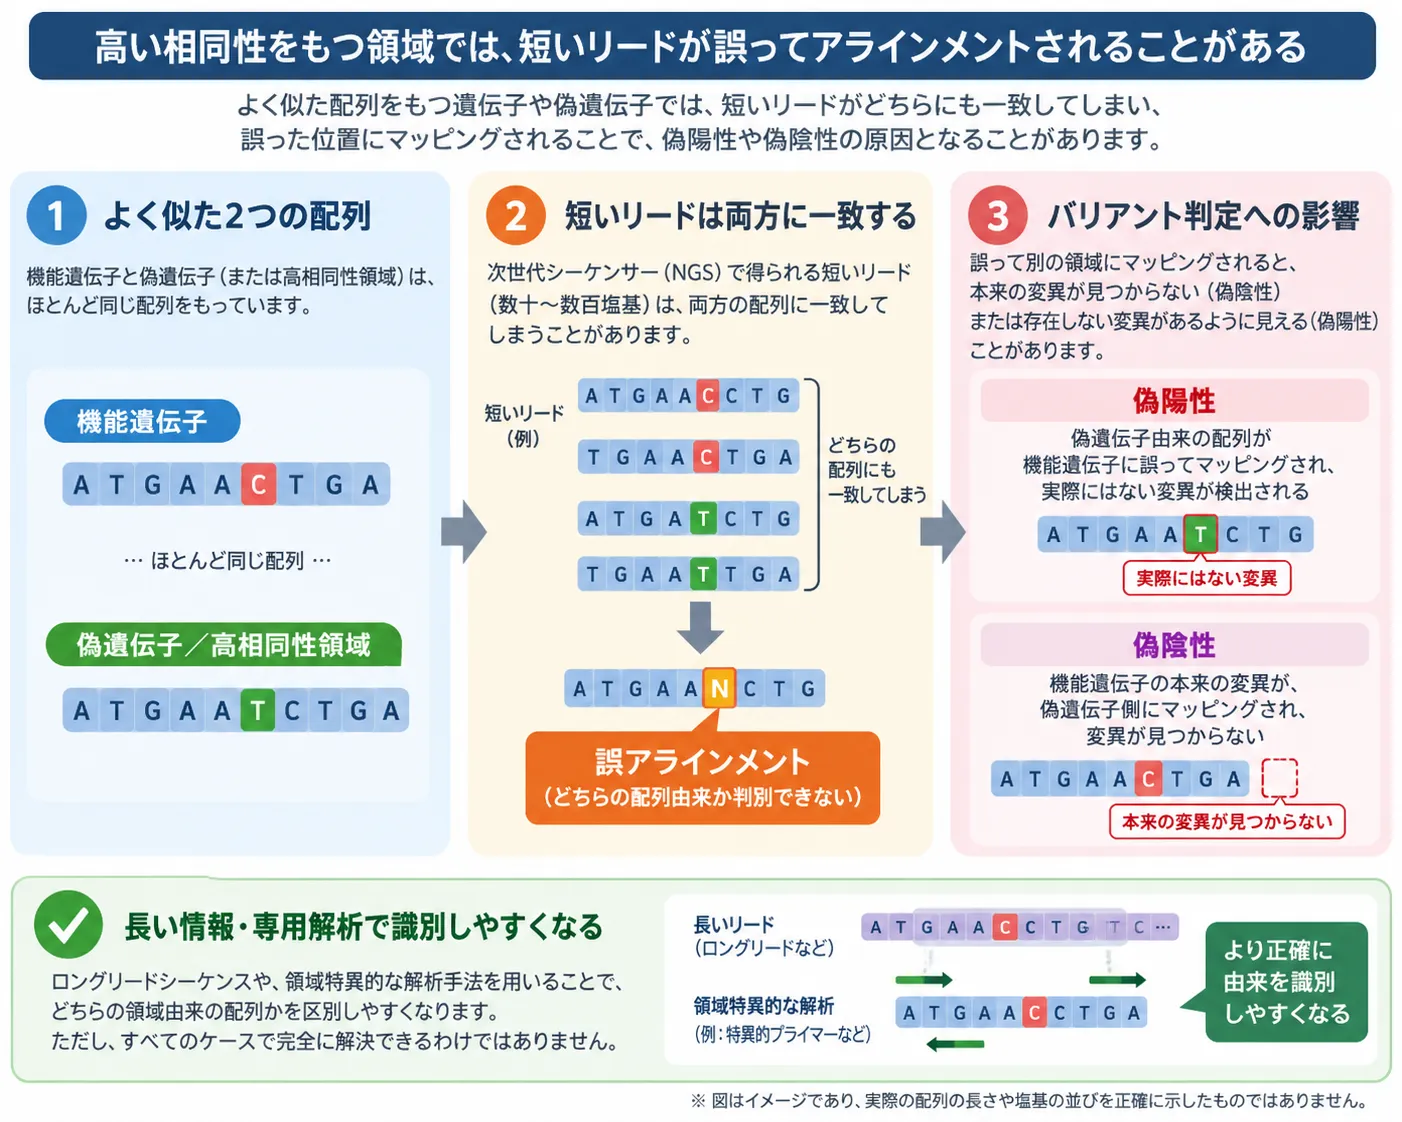
機能遺伝子と偽遺伝子など、非常によく似た配列がゲノム内に存在すると、短いNGSリードが本来とは異なる領域へマッピングされることがあります。こうした誤アラインメントは、存在しないバリアントを検出する偽陽性や、実在するバリアントを見逃す偽陰性の原因になります。ロングリードシーケンスや領域特異的な解析法は、配列の由来を区別しやすくする方法の一つです。
⚠️ 「NGSで何も見つからなかった」の意味には注意が必要
相同性の高い領域は、標準的なNGS解析だけでは正確に評価できないことがあります。このような領域では、NGSの結果に異常がないことが、その遺伝子に異常がないことを必ずしも意味しません。検査によっては、コピー数を測る別の方法や、特定の遺伝子専用の解析、長い断片を読めるロングリードシーケンスなどで補います。検査報告書に記載された「解析対象外の領域」や「限界」の欄にも目を通すことが大切です。
参照ゲノムそのものの改良も進んでいます。現在広く使われている参照ゲノムGRCh38に対し、2022年に発表された研究では、染色体の端から端まで切れ目なく決定したT2T-CHM13ゲノムを参照に使うと、約2億塩基対の配列が加わり、リードのマッピングとバリアント検出が改善し、臨床的に重要な269遺伝子で偽陽性が最大12分の1に減ったと報告されています[20]。また、1本のリードで長い範囲を読めるロングリードシーケンサーは、似た配列の違いを含めて読み取れるため、相同性の高い領域の解析に役立つと期待されています。ただし、どの方法にもそれぞれの限界があり、一つの技術ですべてが解決するわけではありません。
NIPTもリードのマッピングの上に成り立っている
妊婦さんの血液中のcfDNAを解析し、胎児の染色体数的異常の可能性を評価するNIPT(非侵襲的出生前遺伝学的検査)も、アラインメントの技術を土台にしています。母体血中に含まれるDNA断片を大量に読み取り、それぞれを参照ゲノムに並べて「どの染色体に由来するか」を決め、染色体ごとの断片の割合を数えるのが基本的な仕組みです。2008年の研究は、母体血漿中のDNAを大規模並列シークエンスで定量し、21番染色体に由来する配列の割合から胎児の21トリソミーを判別する方法を示しました[21]。どの染色体に由来するかを正しく決められなければ、割合の計算も成り立ちません。リードを染色体ごとに数える具体的な仕組みは、WGSベースのNIPTとリードの密度の解説で詳しく扱っています。
6. バリアント解釈とアラインメント:進化の中で保存された場所を読む
多重配列アラインメントは、見つかったバリアントが「進化の中で保たれてきた重要な位置」にあるかどうかを調べるために使われ、病原性を判断する材料の一つになります。ただし、あくまで判断材料の一つであり、それだけで結論を出すことはできません。
多重配列アラインメントで見る保存性
ヒトの遺伝子と、それに相当する多くの生物種の遺伝子を多重配列アラインメントで並べると、どの種でも同じアミノ酸が保たれている位置と、種によってばらばらな位置が見えてきます。長い進化の間に変化が許されなかった位置は、タンパク質の機能や構造にとって重要である可能性が高いと考えられます。MSAの用途として、機能上重要な残基の検出が挙げられるのはこのためです[8][11]。
また、置き換わった先のアミノ酸の性質も手がかりになります。置換行列が性質の似たアミノ酸への置換に高い点数を与えるのと同じ考え方で[6]、性質の近いアミノ酸への保存的置換より、大きさや電荷が大きく異なるアミノ酸への非保存的置換のほうが、機能への影響が大きい可能性があります。ただし、よく保存された位置のバリアントがすべて病気を起こすわけではなく、保存性は病原性を示唆する根拠であって証明ではありません。保存性と病原性の間にあるのは相関であり、個々のバリアントについて因果関係を示すには、家系内での発症者との一致や機能解析など、別の種類の根拠が必要です。
計算予測ツールとACMG/AMPガイドラインでの位置づけ
保存性やアミノ酸の性質などを組み合わせて、バリアントの影響をコンピュータで予測するツールが数多く開発されています。2015年のACMG/AMPガイドラインでは、こうした計算予測による根拠を、病原性を支持するPP3、良性を支持するBP4という基準で、原則として「補助的(supporting)」な重みの根拠として扱いました[16]。スプライシングへの影響を予測するSpliceAIのようなAIツールも、この計算予測の一種です。
この扱いは2022年に更新されています。ClinGen(臨床ゲノムリソース)の作業部会は、ミスセンスバリアントの予測ツール13種について、スコアと病原性の関係を較正(キャリブレーション)し、多くのツールが補助的なレベル、複数のツールが中等度、いくつかのツールが強いレベルの根拠に達するスコアの閾値を示しました[22]。つまり、予測ツールの結果は、較正された閾値に基づいて使う場合に限って、より強い根拠として扱える場合があるということであり、「予測ツールで病的と出たから病的」と判断してよいわけではありません。計算予測だけでは分類が決まらず、意義不明のバリアント(VUS)にとどまることも少なくありません。
🩺 院長コラム【「よく似ている」と「同じもの」は違う】
アラインメントは、配列が「どれだけ似ているか」を教えてくれる強力な道具です。しかし遺伝医療では、似ていることが、かえって落とし穴になる場面があると考えています。SMN1とSMN2のように、ほとんど同じ配列が並んでいる領域では、短いリードがどちらの遺伝子に由来するのかを決めること自体が難しくなります。ここでの誤りは、結果の数字だけを見ていても気づけません。
検査結果を解釈するときに重要なのは、「どのような方法で、ゲノムのどの範囲を、どこまでの確かさで調べた結果なのか」を確認することだと考えています。アラインメントの仕組みを知っておくことは、検査で分かることと分からないことを正しく区別するための土台になります。
7. 系統樹・タンパク質研究での応用
アラインメントは、生物の進化の道筋をたどる系統樹の作成や、タンパク質の機能・構造の予測を支える基礎技術です。近年は、AIによるタンパク質の立体構造予測にも多重配列アラインメントが活用されています。
系統樹解析の土台としてのアラインメント
生物や遺伝子の進化的な関係を枝分かれの図で表したものを系統樹といい、それを研究する分野を系統発生学と呼びます。分子のデータから系統樹を作るには、まず比べる配列を多重配列アラインメントで並べ、同じ列に並んだ文字どうしが「同じ祖先の位置に由来する」とみなしたうえで、違いの数やパターンから関係を推定します。ClustalWの原著論文も、MSAを分子進化解析に欠かせない前段階として位置づけています[8]。アラインメントの誤りは、そのまま系統樹の誤りにつながります。系統樹の推定にはMEGAなどの統合ソフトが広く使われています[13]。
保存されたドメインの同定と機能予測
多重配列アラインメントでタンパク質ファミリーの配列を並べると、多くの配列で共通して保たれているドメインやモチーフ(特徴的な短い配列パターン)が見えてきます[8]。機能がわかっていない新しい遺伝子やタンパク質でも、既知のファミリーの配列とアラインメントして共通のドメインが見つかれば、その働きを推測する手がかりになります。ただし、配列が似ていることから推測された機能は、実験で確かめられるまでは「予測」にとどまります。
AI時代のアラインメント:AlphaFold2と多重配列アラインメント
アミノ酸配列からタンパク質の立体構造を予測するAIとして知られるAlphaFold2は、多重配列アラインメントを深層学習モデルの設計に組み込んでいます。2021年の原著論文では、構造予測の国際的な評価(CASP14)で、多くのケースで実験で決めた構造に匹敵する精度を示したと報告されています[23]。多くの生物種の配列を並べた情報には、進化の中でどの位置がどのように変化してきたかが記録されており、それが立体構造を推定する手がかりになるためです。AIの進歩によってアラインメントが不要になったのではなく、アラインメントで得られる進化の情報が、AIの予測を支える材料として使われていると理解するのが正確です。
よくある質問(FAQ)
Q1. アラインメントとは簡単にいうと何ですか?
DNA・RNA・タンパク質の配列を、似ている部分が縦にそろうように並べて比べる解析のことです。並べた結果から、同じ文字が並んでいる位置(一致)、別の文字に置き換わっている位置(ミスマッチ)、片方にだけ文字がある位置(ギャップ)を読み取り、配列どうしがどれくらい似ているかを評価します。
Q2. アライメントとアラインメントはどちらが正しいですか?
どちらも英語の alignment をカタカナにしたもので、意味は同じです。どちらかが誤りということはなく、分野や書き手によって使い分けられています。
Q3. 多重配列アラインメント(MSA)とは何ですか?
3本以上の配列を同時に並べ、どの位置が多くの配列で共通して保たれているかを一覧できるようにする方法です。特徴的な領域の発見、系統樹の作成、バリアントが保存された位置にあるかの確認などに使われます。多くのツールは近似的な方法を使うため、結果は設定によって細部が変わりうる推定です。
Q4. マッピングとアラインメントの違いは何ですか?
マッピングは、次世代シークエンサーで読み取った大量の短いDNA断片(リード)が、参照ゲノムのどこに由来するかを決める作業です。アラインメントは配列どうしの塩基・アミノ酸の対応関係を決める操作で、リードマッピングでは通常アラインメント計算が使われます。NGSでは両者が近い意味で使われることもありますが、厳密には位置決定と配列対応付けという違いがあります。
Q5. 相同性とアラインメントはどう関係していますか?
アラインメントは配列どうしの類似性や同一性を測る道具で、相同性はその結果から推定される「共通の祖先に由来するかどうか」という関係です。相同性は本来「ある/ない」の概念であり、「相同性◯%」と表されているものは、厳密には同一性や類似性の割合を指しています。
Q6. 遺伝子検査でアラインメントの誤りは起こりますか?
起こりえます。特に、偽遺伝子や重複した配列など、ほとんど同じ配列がゲノム内に複数ある領域では、短いリードの由来を正しく決められず、偽陽性や偽陰性の原因になることがあります。SMN1やCYP21A2、PMS2などがその例で、検査によっては別の方法や専用の解析で補います。検査報告書の解析範囲や限界の記載を確認することが大切です。
まとめ
アラインメント(アライメント)とは、配列を対応する文字が同じ列に来るように並べて比べる解析で、一致・ミスマッチ・ギャップに与えた点数の合計が最も高い並べ方が「最適なアラインメント」として選ばれます。遺伝医療では、NGSのリードを参照ゲノムに並べるマッピングとして遺伝学的検査やNIPTの解析の出発点になり、多重配列アラインメントはバリアントの保存性を評価する材料になります。一方で、似た配列が多い領域では誤アラインメントが起こりうること、保存性や計算予測は病原性を判断する材料の一つにすぎないこともあわせて理解しておく必要があります。
🏥 遺伝子検査についてのご相談
遺伝子検査で何が分かり、何が分からないのか、
検査の方法や解析範囲について知りたい方は、
臨床遺伝専門医が在籍するミネルバクリニックにお問い合わせください。
参考文献
- [1] Needleman SB, Wunsch CD. A general method applicable to the search for similarities in the amino acid sequence of two proteins. J Mol Biol. 1970;48(3):443-453. [DOI 10.1016/0022-2836(70)90057-4]
- [2] Reeck GR, et al. “Homology” in proteins and nucleic acids: a terminology muddle and a way out of it. Cell. 1987;50:667. [PDF]
- [3] IUPAC-IUB JCBN / NC-IUB. The meaning of the terms ‘homology’ and ‘homologous’ (Newsletter 1989). IUBMB Nomenclature. [IUBMB]
- [4] Smith TF, Waterman MS. Identification of common molecular subsequences. J Mol Biol. 1981;147(1):195-7. [PubMed 7265238]
- [5] Altschul SF, et al. Basic local alignment search tool. J Mol Biol. 1990;215(3):403-10. [PubMed 2231712]
- [6] Henikoff S, Henikoff JG. Amino acid substitution matrices from protein blocks. Proc Natl Acad Sci U S A. 1992;89(22):10915-9. [PubMed 1438297]
- [7] DNAデータバンク(DDBJ). 相同性検索プログラムBLASTの内部構造. DDBJ. [DDBJ]
- [8] Thompson JD, Higgins DG, Gibson TJ. CLUSTAL W: improving the sensitivity of progressive multiple sequence alignment through sequence weighting, position-specific gap penalties and weight matrix choice. Nucleic Acids Res. 1994;22(22):4673-80. [PubMed 7984417]
- [9] Sievers F, et al. Fast, scalable generation of high-quality protein multiple sequence alignments using Clustal Omega. Mol Syst Biol. 2011;7:539. [PMC3261699]
- [10] Notredame C, Higgins DG, Heringa J. T-Coffee: A novel method for fast and accurate multiple sequence alignment. J Mol Biol. 2000;302(1):205-17. [PubMed 10964570]
- [11] Katoh K, et al. MAFFT: a novel method for rapid multiple sequence alignment based on fast Fourier transform. Nucleic Acids Res. 2002;30(14):3059-3066. [PMC135756]
- [12] Edgar RC. MUSCLE: multiple sequence alignment with high accuracy and high throughput. Nucleic Acids Res. 2004;32(5):1792-7. [PubMed 15034147]
- [13] Kumar S, et al. MEGA12: Molecular Evolutionary Genetic Analysis Version 12 for Adaptive and Green Computing. Mol Biol Evol. 2024;41(12):msae263. [PMC11683415]
- [14] Li H, Durbin R. Fast and accurate short read alignment with Burrows-Wheeler transform. Bioinformatics. 2009;25(14):1754-60. [PubMed 19451168]
- [15] NLM/NCBI Workshop. BLAST Statistics: The Expect Value. National Library of Medicine. [NLM]
- [16] Richards S, et al. Standards and guidelines for the interpretation of sequence variants: a joint consensus recommendation of the American College of Medical Genetics and Genomics and the Association for Molecular Pathology. Genet Med. 2015;17(5):405-24. [PubMed 25741868]
- [17] Mandelker D, et al. Navigating highly homologous genes in a molecular diagnostic setting: a resource for clinical next-generation sequencing. Genet Med. 2016;18(12):1282-1289. [Genet Med]
- [18] Lee H, Yen HY, Zhong AW, Gao H. Resolving misalignment interference for NGS-based clinical diagnostics. Hum Genet. 2021;140(3):477-492. doi:10.1007/s00439-020-02216-5. [PubMed 32915251]
- [19] Lorson CL, et al. A single nucleotide in the SMN gene regulates splicing and is responsible for spinal muscular atrophy. Proc Natl Acad Sci U S A. 1999;96(11):6307-6311. [PMC26877]
- [20] Aganezov S, et al. A complete reference genome improves analysis of human genetic variation. Science. 2022;376(6588):eabl3533. [PubMed 35357935]
- [21] Chiu RWK, et al. Noninvasive prenatal diagnosis of fetal chromosomal aneuploidy by massively parallel genomic sequencing of DNA in maternal plasma. Proc Natl Acad Sci U S A. 2008;105(51):20458-63. [PubMed 19073917]
- [22] Pejaver V, et al. Calibration of computational tools for missense variant pathogenicity classification and ClinGen recommendations for PP3/BP4 criteria. Am J Hum Genet. 2022;109(12):2163-2177. [PubMed 36413997]
- [23] Jumper J, et al. Highly accurate protein structure prediction with AlphaFold. Nature. 2021;596(7873):583-589. [PubMed 34265844]






